Wan2.1とは?
Wan2.1 は、アリババが開発したオープンソースの動画生成モデルです。
オープンソース界隈で、本格的に動画生成が行われるようになった火付け役ともいえる、印象的なモデルです。
text2video、image2video、FLF2V の 3 つのモードに対応しています。
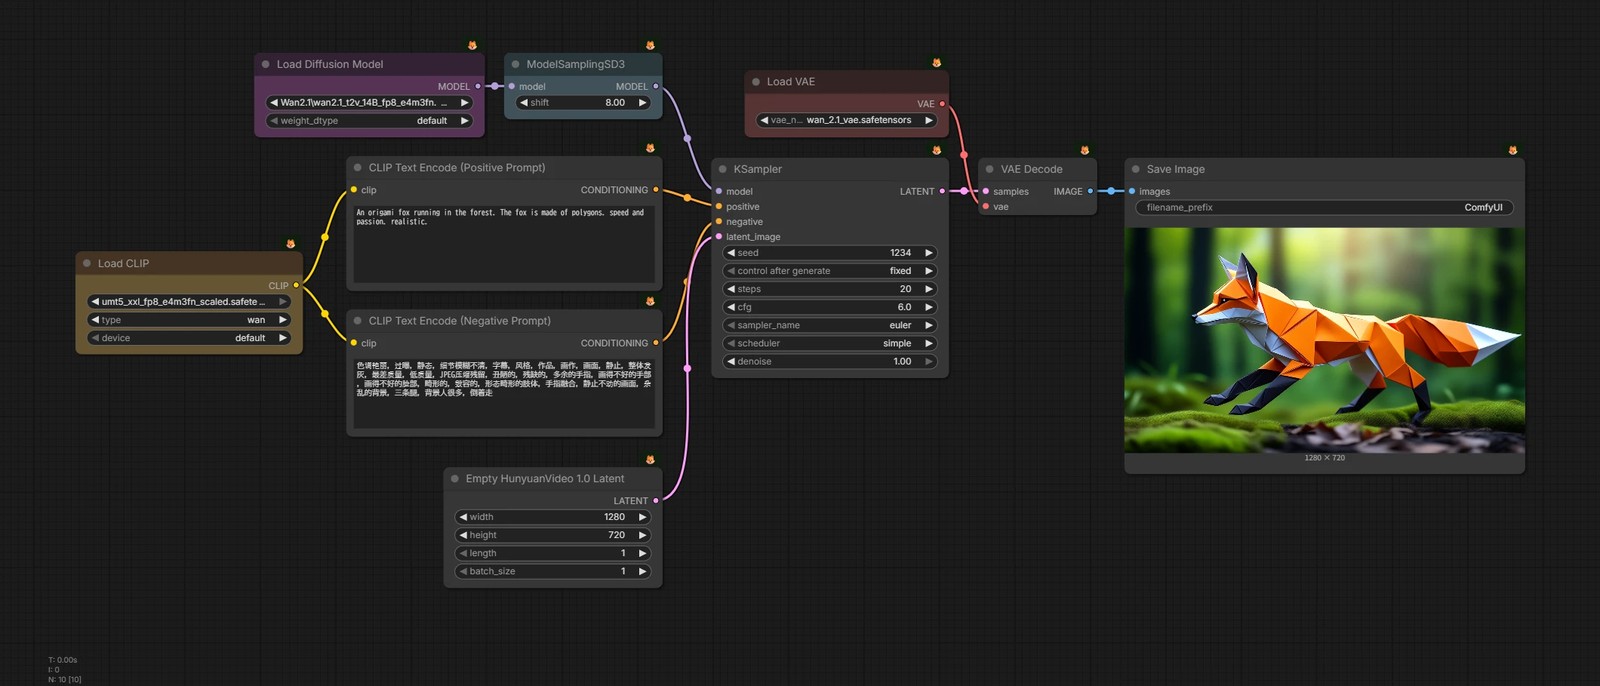
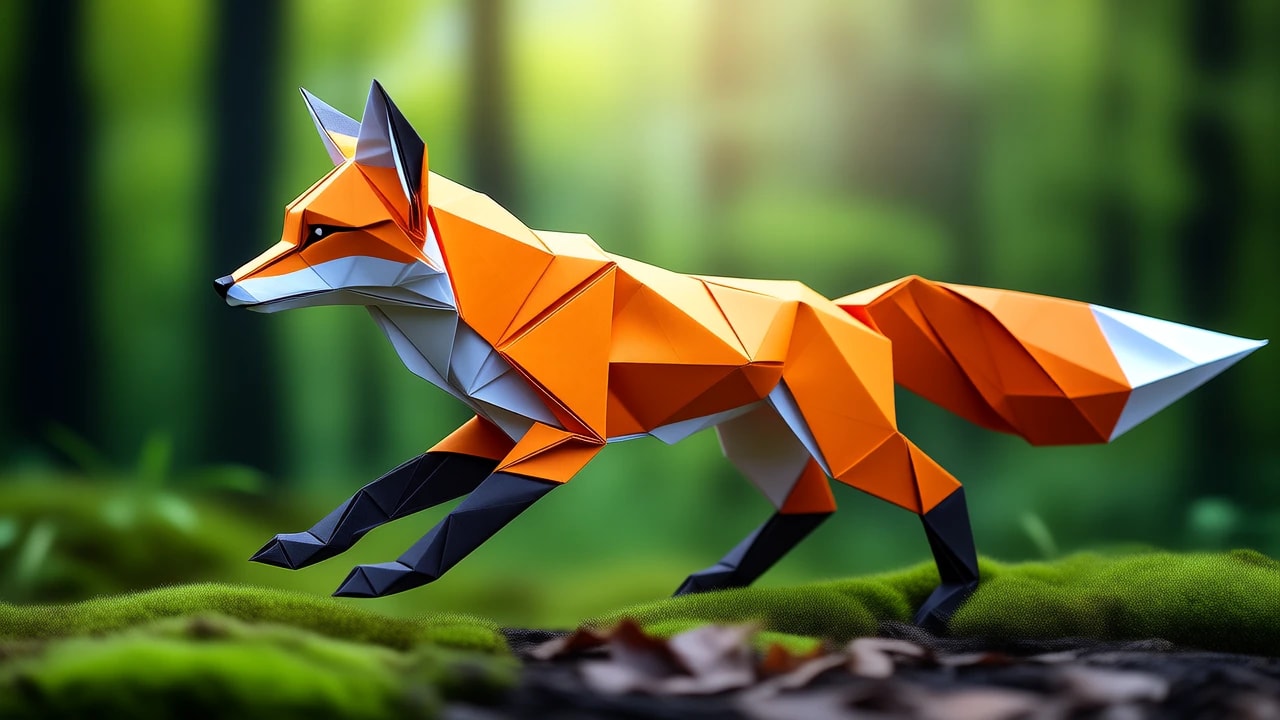
また、1 フレームだけ生成することで、画像生成モデルとしても使用できます。
細かい話にはなりますが、これは「動画生成が画像生成を内包している」というわけではなく、最初から画像生成もできるように設計された動画生成モデルです。
1.3B と 14B の 2 つのモデルサイズが用意されていますが、1.3B はさすがに性能が足りずほとんど使われていないため、ここでは 14B のみ使っていきます。
推奨設定
- 推奨解像度
- 480p(854×480)〜 720p(1280×720)
- 最大フレーム数
- 81 フレーム
- FPS
- 16fps 付近で出力されることが多い
16fps だとスローモーションのような動画になることが多いので、24fps で保存したり、コマ落としで調整したりしてください。
モデルのダウンロード
- diffusion models
- text encoder
- VAE
- gguf (任意)
📂ComfyUI/
└── 📂models/
    ├── 📂diffusion_models/
    │   ├── wan2.1_t2v_14B_fp8_e4m3fn.safetensors
    │   ├── wan2.1_i2v_720p_14B_fp8_e4m3fn.safetensors
    │   └── wan2.1_flf2v_720p_14B_fp8_e4m3fn.safetensors
    ├── 📂text_encoders/
    │   └── umt5_xxl_fp8_e4m3fn_scaled.safetensors
    ├── 📂unet/
    │   ├── wan2.1-t2v-14b-XXXX.gguf          ← gguf を使う場合のみ
    │   ├── wan2.1-i2v-14b-720p-XXXX.gguf     ← gguf を使う場合のみ
    │   └── wan2.1-flf2v-14b-720p-XXXX.gguf   ← gguf を使う場合のみ
    └── 📂vae/
        └── wan_2.1_vae.safetensors
fp16 / bf16 版を使いたい場合は、上の fp8 のファイル名を読み替えてください。基本的な配置パスは同じです。
text2video
Wan2.1 の基本となる text2video の workflow です。
-
🟦
ModelSamplingSD3ノードのShiftは、動きの大きさに効くパラメータです。- 上げるほどカメラワークや被写体の変化が大きくなりますが、大きすぎれば崩れる原因になります。ひとまず
8のままで問題ないでしょう。 - cf. Wan2.1 parameter sweep
- 上げるほどカメラワークや被写体の変化が大きくなりますが、大きすぎれば崩れる原因になります。ひとまず
品質が上がるかもしれない技術
体感できるほどではないですが、ほぼノーデメリットで品質を上げる技術がコアノードとして実装されているので、使っておきましょう。
-
🟦 UNetTemporalAttentionMultiply
- フレーム間の一貫性を補強し、チラつきを抑制します。
-
🟦 CFG-Zero
- サンプリング序盤の CFG を弱めることで、過剰な補正による破綻を防ぎます。
image2video
画像を与えると、その画像から続きを生成します。
- 🟩 適度にリサイズした画像を
CLIP Vision EncodeとWanImageToVideoの両方に入力します。
FLF2V(First–Last Frame to Video)
2 枚の画像を与えて、その間が自然に埋まるように動画を生成します。
- 🟩 2 枚の画像をバッチにして
WanFirstLastFrameToVideoノードに入力します。
Self Forcing(高速生成)
本来はリアルタイム動画生成のための技術ですが、ComfyUI では単なる数ステップ生成による高速化手法として使います。
モデルのダウンロード
-
loras
📂ComfyUI/
└── 📂models/
    └── 📂loras/
        ├── Wan21_T2V_14B_lightx2v_cfg_step_distill_lora_rank64.safetensors
        └── Wan21_I2V_14B_lightx2v_cfg_step_distill_lora_rank64.safetensors
workflow
LoraLoaderModelOnlyノードで LoRA を読み込みます。KSamplerのstepsを 4 ~ 8、CFGを 1.0 に設定します。
Self Forcing は「とにかく高速に回したいとき」の選択肢です。
許容できないほどではないですが、劣化は大きいです。
画像生成
text2video の workflow で、1 フレームで動画生成するだけです。