TRELLIS.2とは?
TRELLIS.2 は、Microsoft が公開した、画像 1 枚から 3D モデルを生成するモデルです。
出力は、色や質感の付いた 3D モデル(PBR テクスチャ付きのメッシュ)です。
Pixal3D
Pixal3D は、清華大学と Tencent ARC Lab などが公開した、TRELLIS.2 ベースの改良版です。
画像の特徴を画素ごとに 3D 空間へ投影してから生成するので、入力画像と 3D モデルが画素単位で対応し、入力画像に忠実な形になります。
モデルのダウンロード
- background_removal
- birefnet.safetensors (444 MB)
- clip_vision
- dino_v3_L_naf_fp32.safetensors (1.22 GB)
- diffusion_models
- trellis_2_int8_convrot.safetensors (5.25 GB)
- TRELLIS.2 用
- pixal3d_int8_convrot.safetensors (5.58 GB)
- Pixal3D 用
- pixal3d_multiview_int8_convrot.safetensors (5.58 GB)
- Pixal3D マルチビュー用
- trellis_2_int8_convrot.safetensors (5.25 GB)
- geometry_estimation
- moge_3_vitl_fp16.safetensors (741 MB)
- Pixal3D 用
- moge_3_vitl_fp16.safetensors (741 MB)
- vae
- trellis_2_shape_vae_bf16.safetensors (1.10 GB)
- trellis_2_texture_vae_bf16.safetensors (948 MB)
📂ComfyUI/
└── 📂models/
    ├── 📂background_removal/
    │   └── birefnet.safetensors
    ├── 📂clip_vision/
    │   └── dino_v3_L_naf_fp32.safetensors
    ├── 📂diffusion_models/
    │   ├── trellis_2_int8_convrot.safetensors
    │   ├── pixal3d_int8_convrot.safetensors
    │   └── pixal3d_multiview_int8_convrot.safetensors
    ├── 📂geometry_estimation/
    │   └── moge_3_vitl_fp16.safetensors
    └── 📂vae/
        ├── trellis_2_shape_vae_bf16.safetensors
        └── trellis_2_texture_vae_bf16.safetensors
TRELLIS.2
非常に巨大な workflow で尻込みしてしまいますが、基本的には入力画像を変えて実行するだけです。
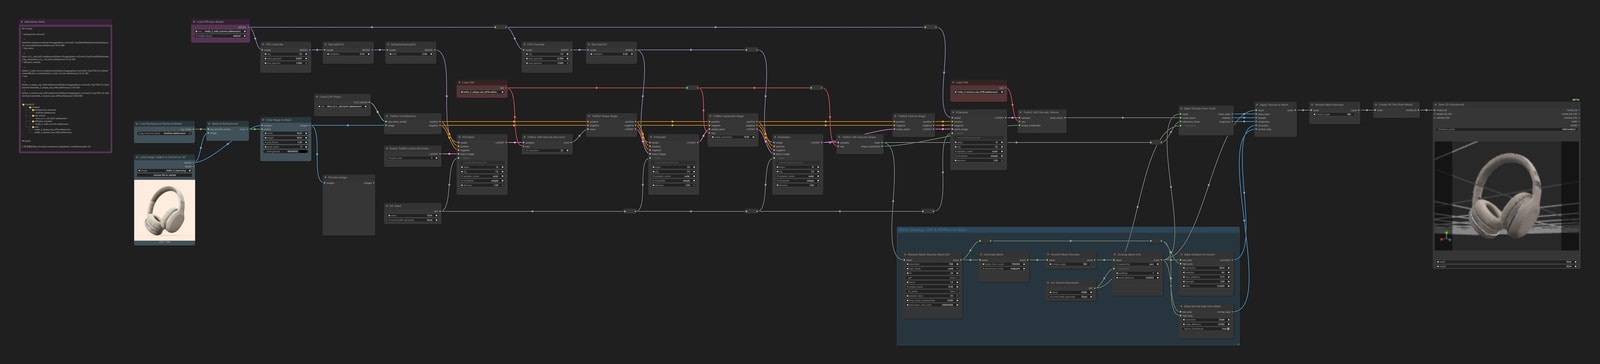
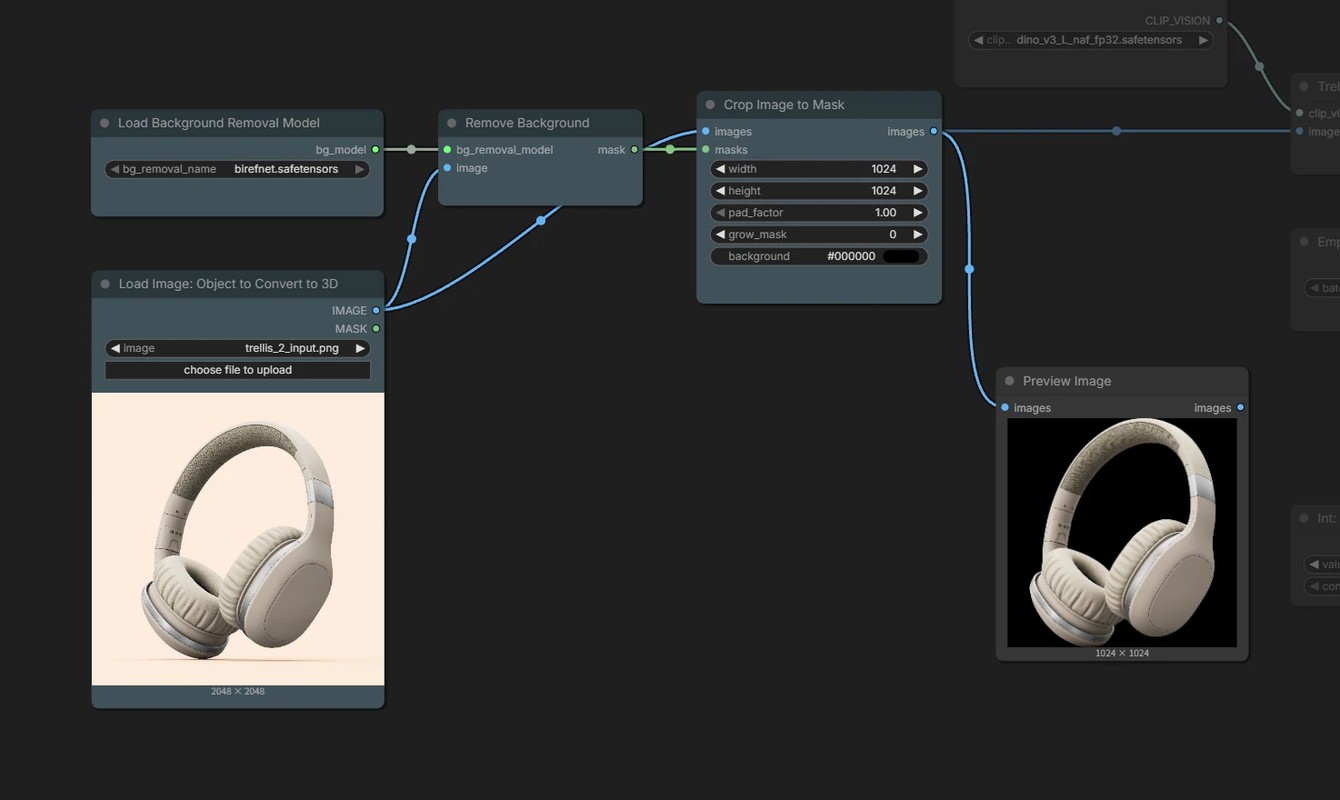
前処理
BiRefNet で背景を除去し、背景が真っ黒の正方形の画像を作ります。
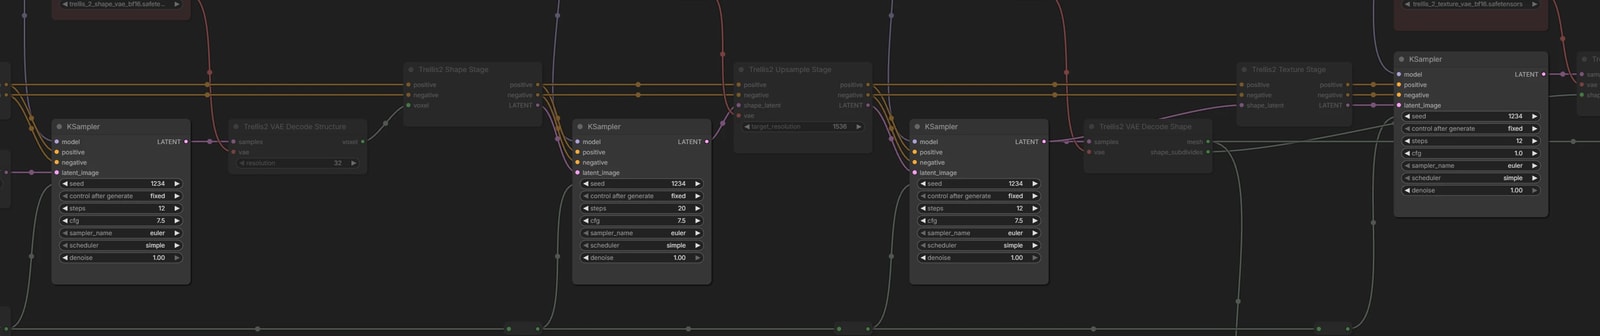
4 回のサンプリング
TRELLIS.2 は、大まかな形から順に 4 回に分けて生成します。
- 1 回目
- 物体がどこにあるか、32³ の粗いボクセルで決める
- 2 回目
- そのボクセルの中に、512 の解像度で形を作る
- 3 回目
- 2 回目の形を 1536 の解像度に引き上げ、形を作り直す
- 4 回目
- できた形に、色と材質を付ける
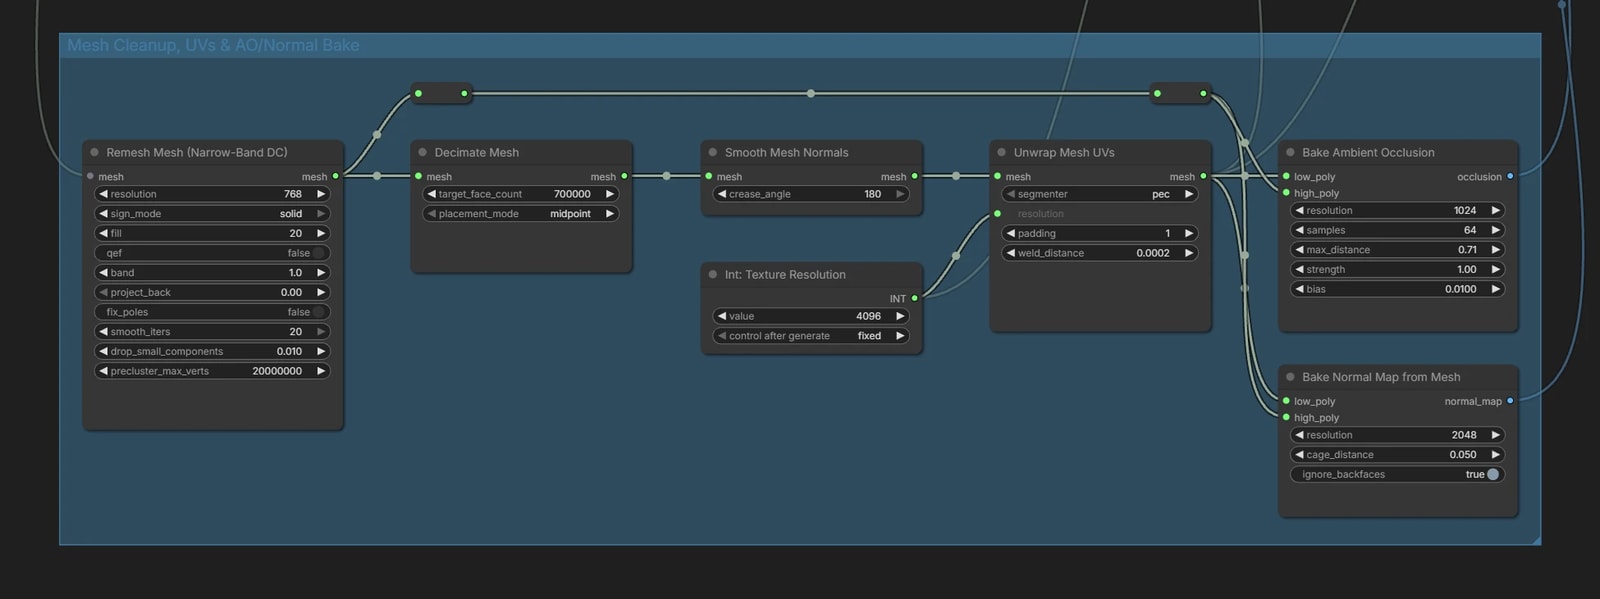
メッシュの後処理
生成されたメッシュを整えてから、テクスチャを焼き付けます。
Remesh Meshで面を均一に作り直し、Decimate Meshで 70 万面まで減らすUnwrap Mesh UVsで UV を展開し、ボクセルの色をテクスチャに焼き付ける- 減らす前のメッシュから、法線マップと AO も焼き付ける
Pixal3D
TRELLIS.2 とほとんど同じですが、FOV(視野角)の入力が増えるため、画像からそれを推定する処理が追加されます。
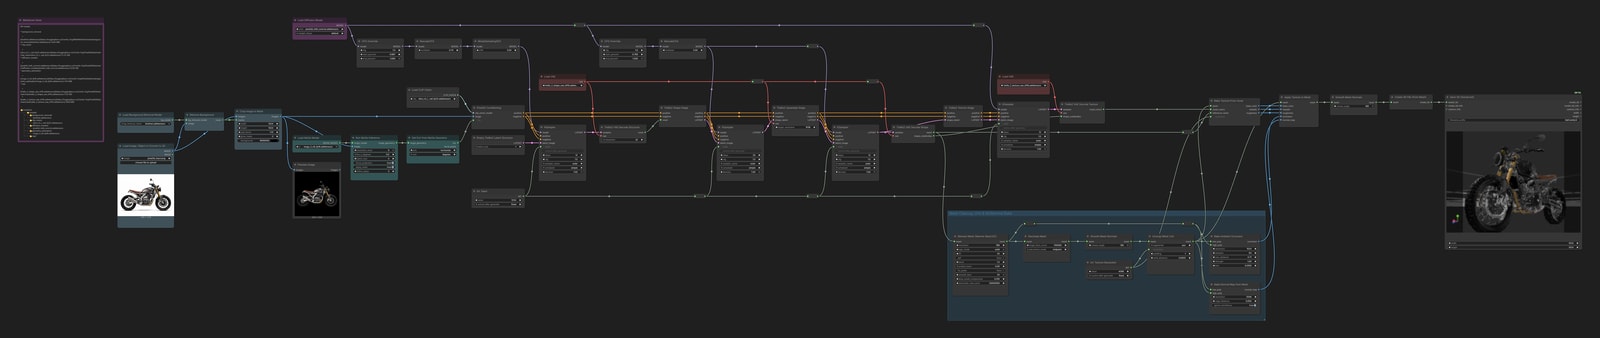
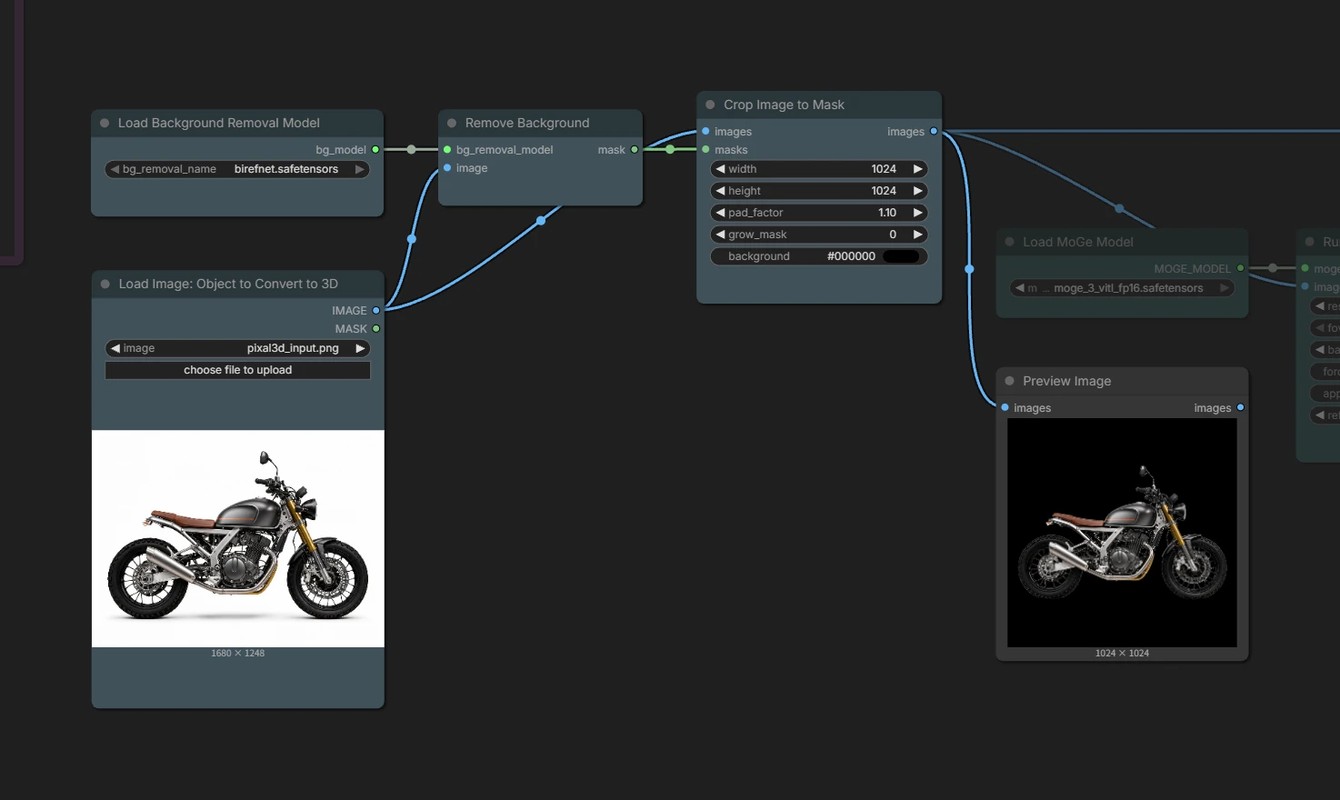
前処理
Crop Image to Mask の pad_factor は、TRELLIS.2 では 1.0 ですが、Pixal3D では 1.1 にしています。
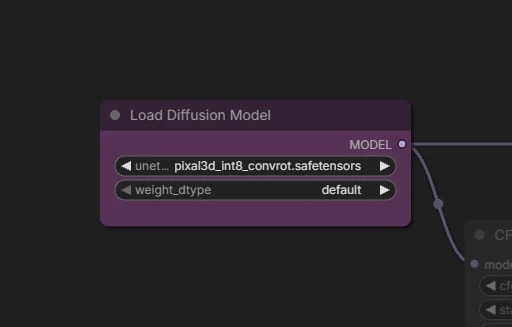
モデル
拡散モデルを pixal3d_int8_convrot.safetensors にします。VAE と DINOv3 は TRELLIS.2 と同じです。
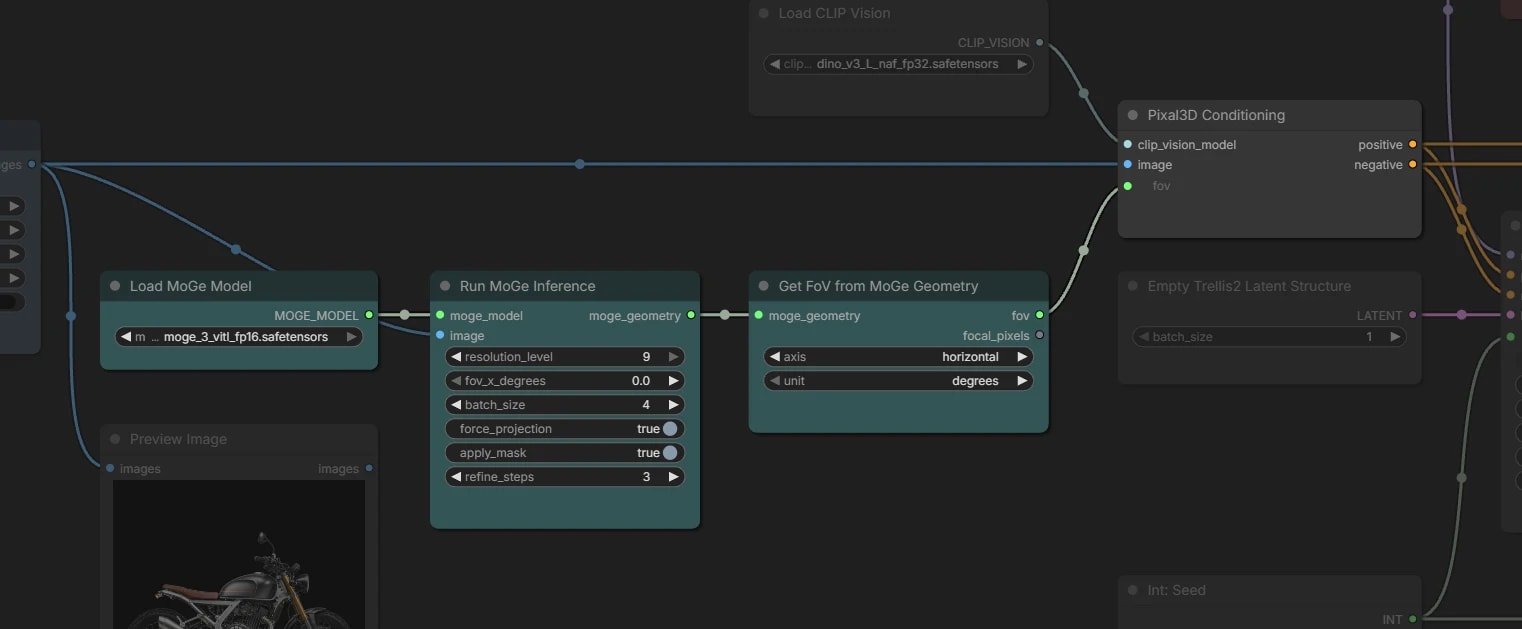
MoGe で視野角を推定する
Pixal3D は、画像を撮ったカメラの視野角(FOV)を使って、画像を 3D 空間に投影します。
この workflow では、FOV の推定に MoGe-3 を使っています。
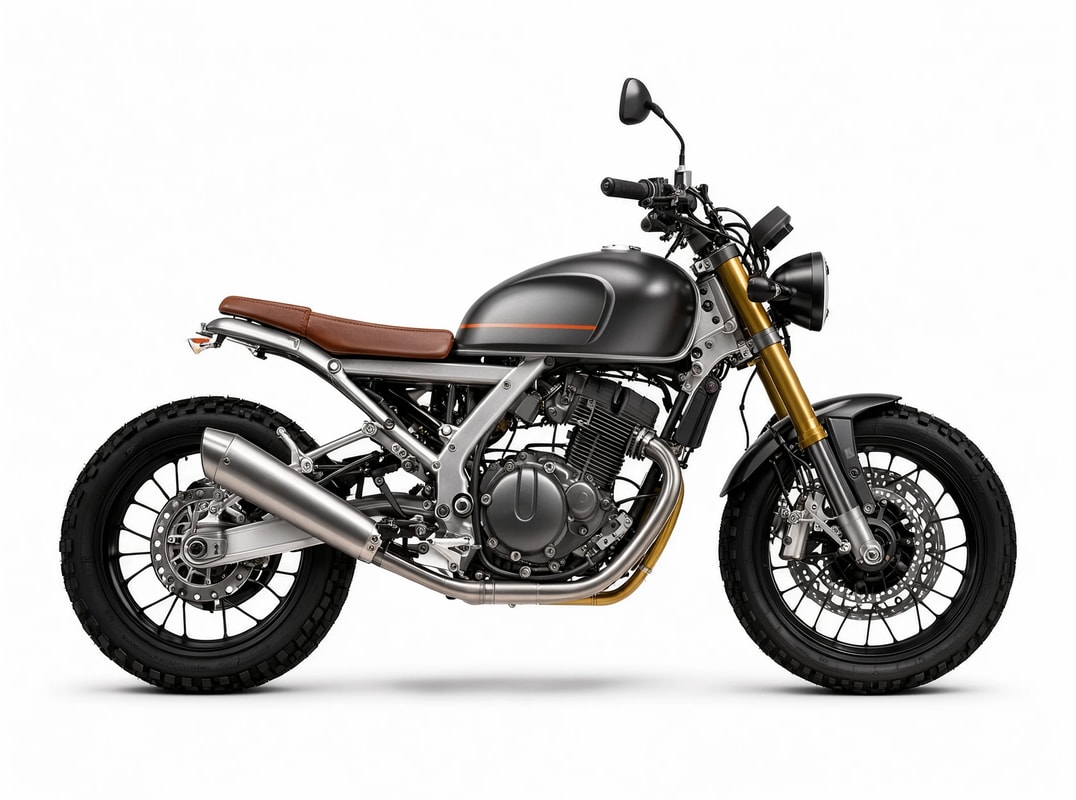
Pixal3D マルチビュー
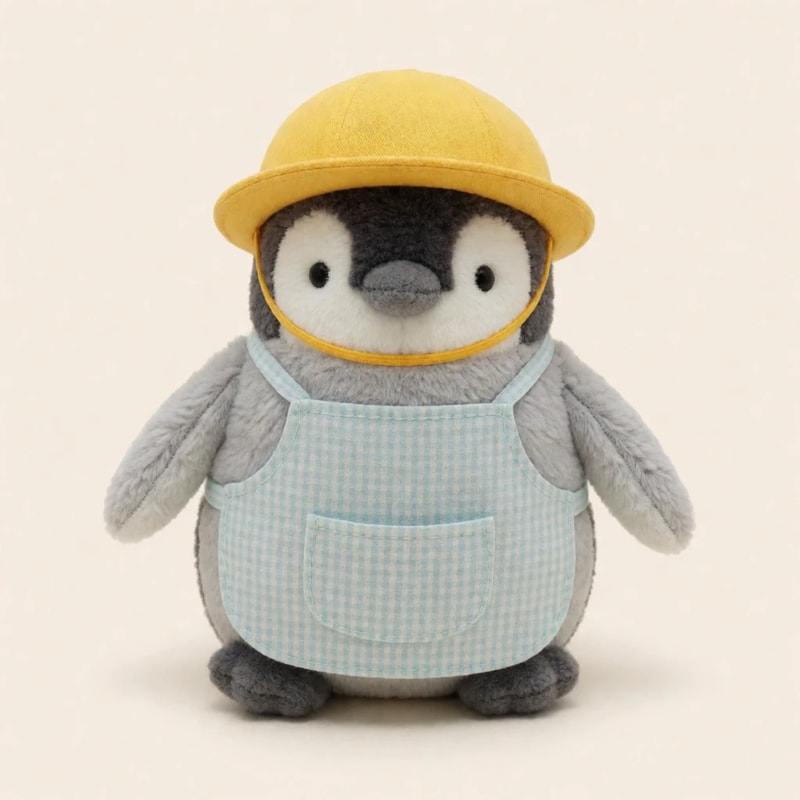
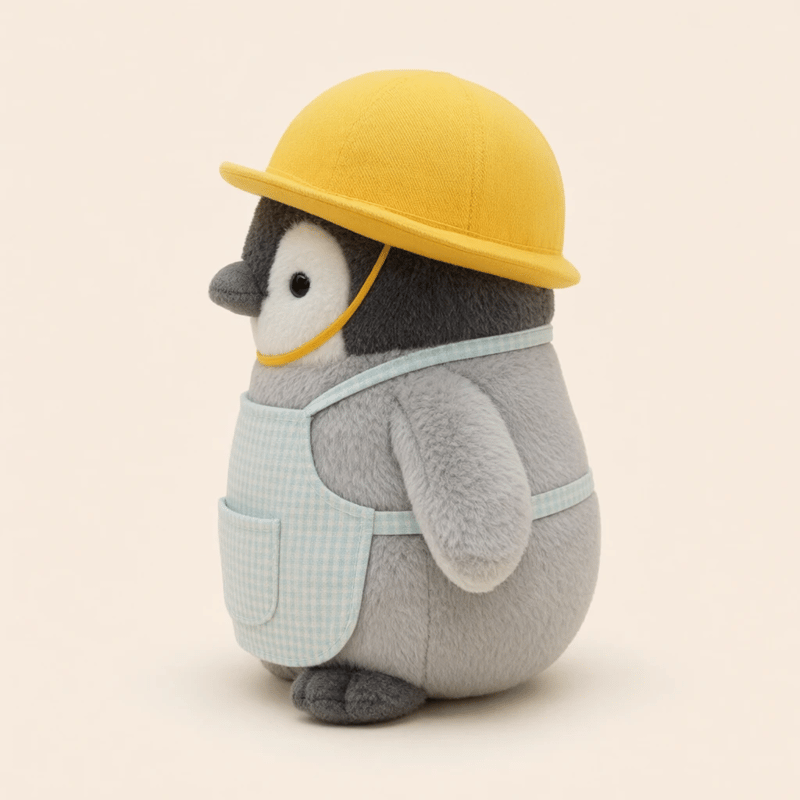
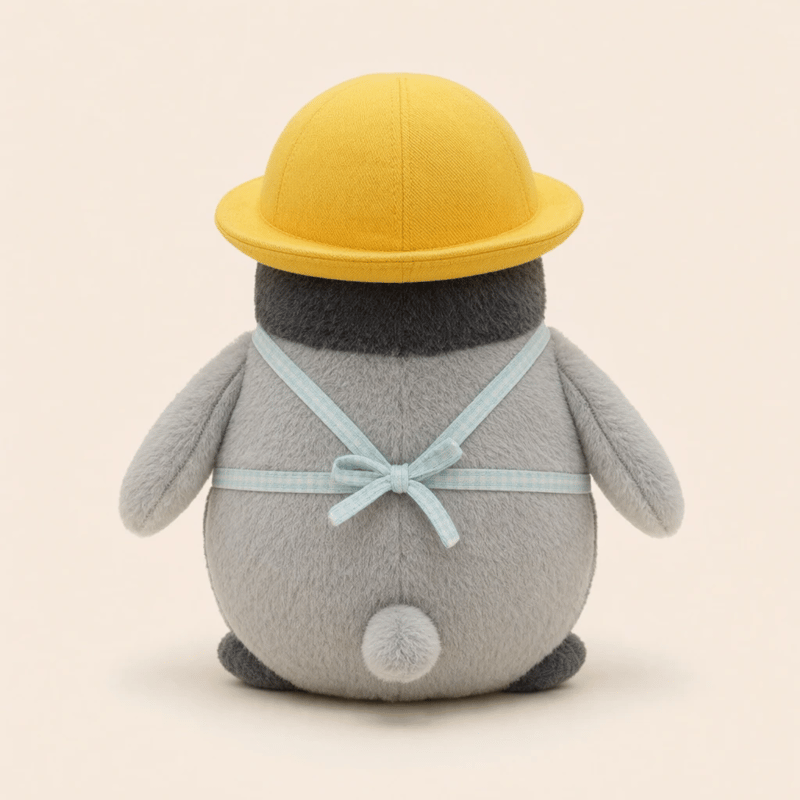
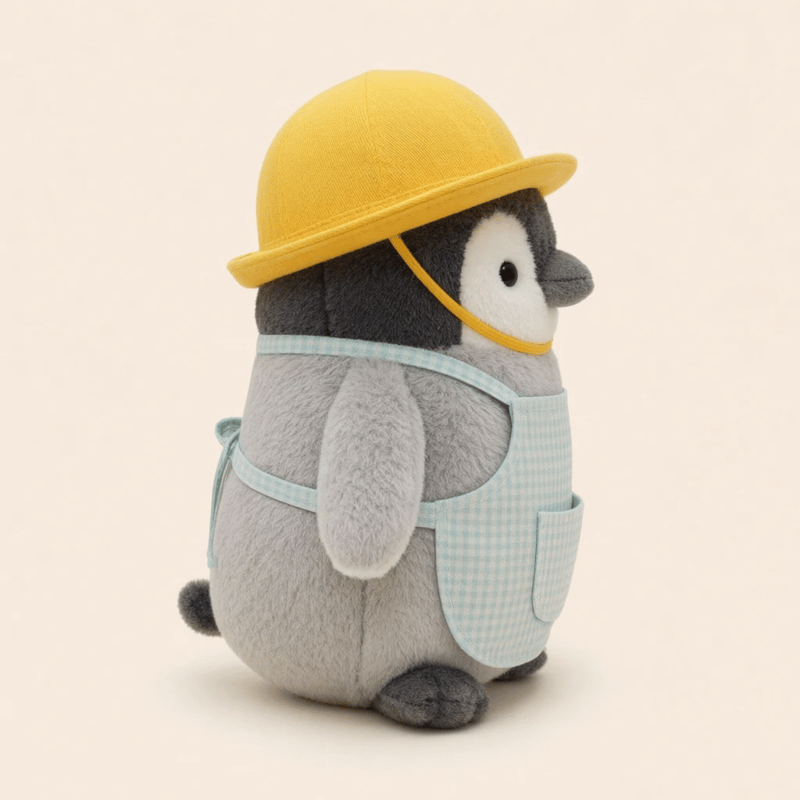
正面・左・背面・右の 4 枚の画像から、3D モデルを生成します。
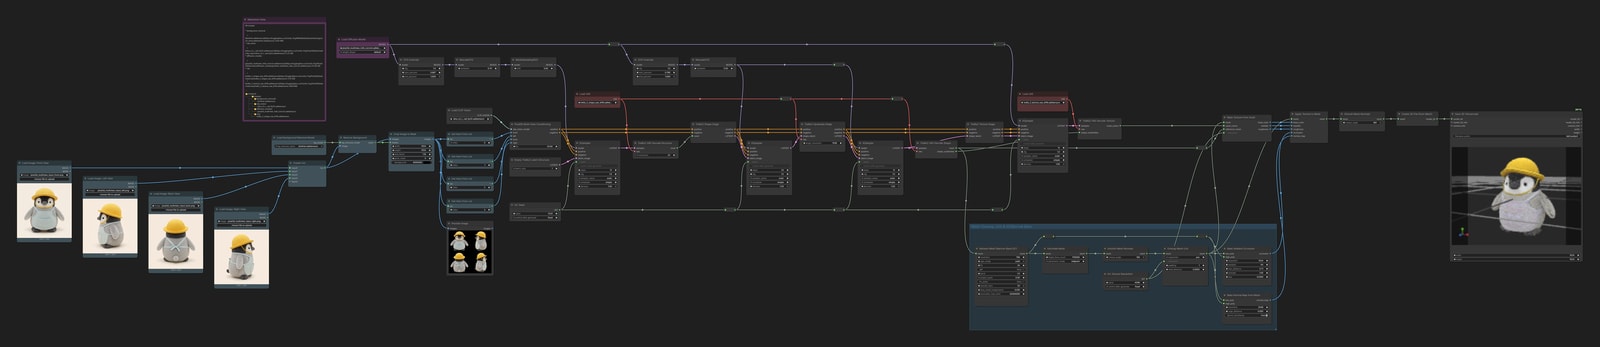
複数視点の画像は、Qwen-Image-2.1 で生成しました。動画生成モデルで回転動画を作ってフレームを抜き出すなど、好きな方法で用意してください。
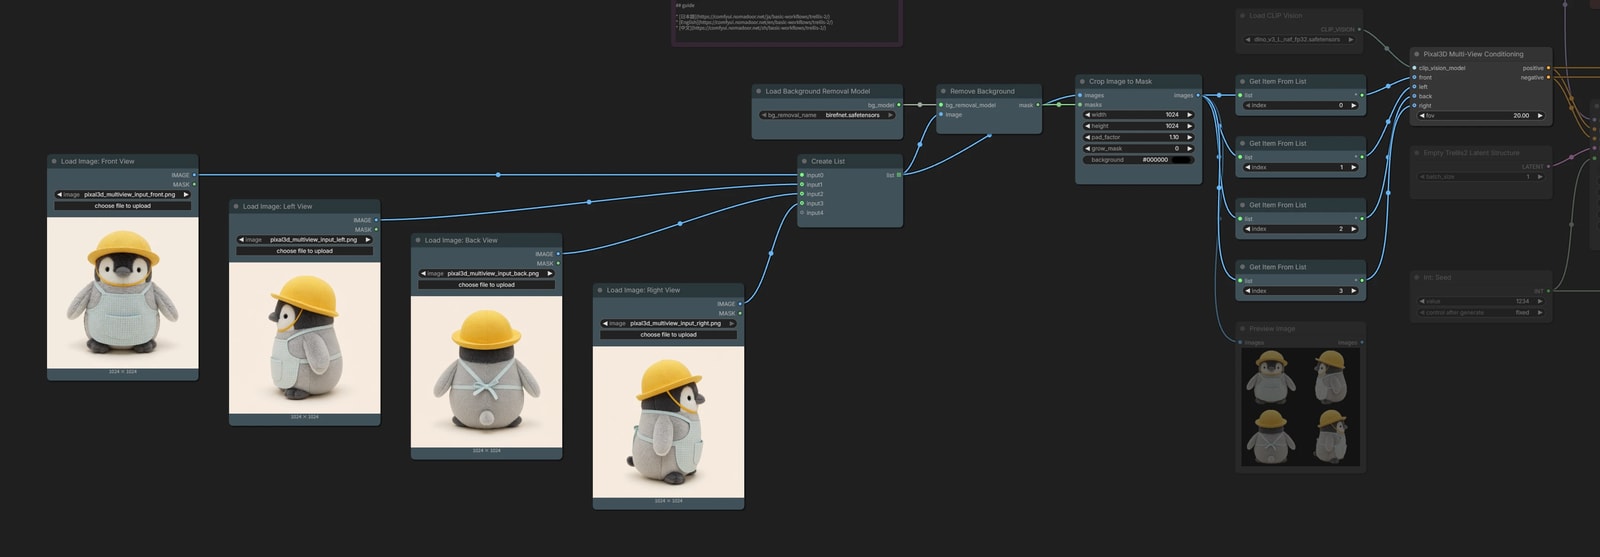
4 視点の入力
4 枚の画像それぞれから、上と同じように背景を黒く塗った画像を作ります。
workflow をコンパクトにするため、ここでは一度リストにまとめて順に処理し、Get Item From List で 1 枚ずつ取り出しています。
fovは既定の 20- 写真を使うときは、MoGe で 1 枚から推定した値を入れたほうがいいかもしれません。