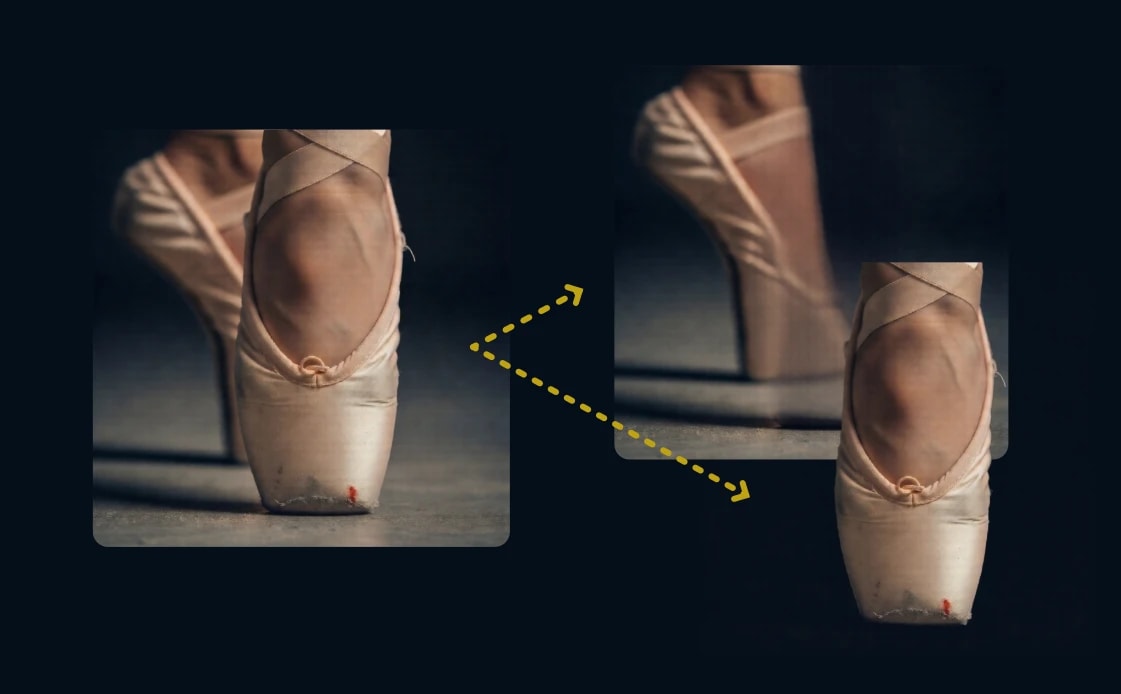
Qwen-Image-Layeredとは?
入力した画像を、任意枚数の レイヤー に分解する拡散モデルです。
昨今流行りの画像編集ですが、指示とは関係ない部分が変化してしまうことがあります。 それならば、これまでデザイナーがやってきたのと同じようにレイヤー分けをして、対象のレイヤーだけ編集すればよいよね?という動機から生まれたタスクですね。
透過画像(RGBA)を扱う初の汎用的な手法であることも注目すべき点です。
これまでの手法だと、後処理が必要だったり、デコード時だけ特殊処理が必要だったりしましたが、より素直に「RGBA画像として扱う」やり方が取られています。
モデルのダウンロード
-
diffusion_models
-
text_encoders
-
vae
-
gguf(任意)
📂ComfyUI/
└── 📂models/
    ├── 📂diffusion_models/
    │   └── qwen_image_layered_fp8mixed.safetensors
    ├── 📂text_encoders/
    │   └── qwen_2.5_vl_7b_fp8_scaled.safetensors
    ├── 📂unet/
    │   └── Qwen_Image_Layered-XXXX.gguf          ← gguf を使う場合のみ
    └── 📂vae/
        └── qwen_image_layered_vae.safetensors
workflow
-
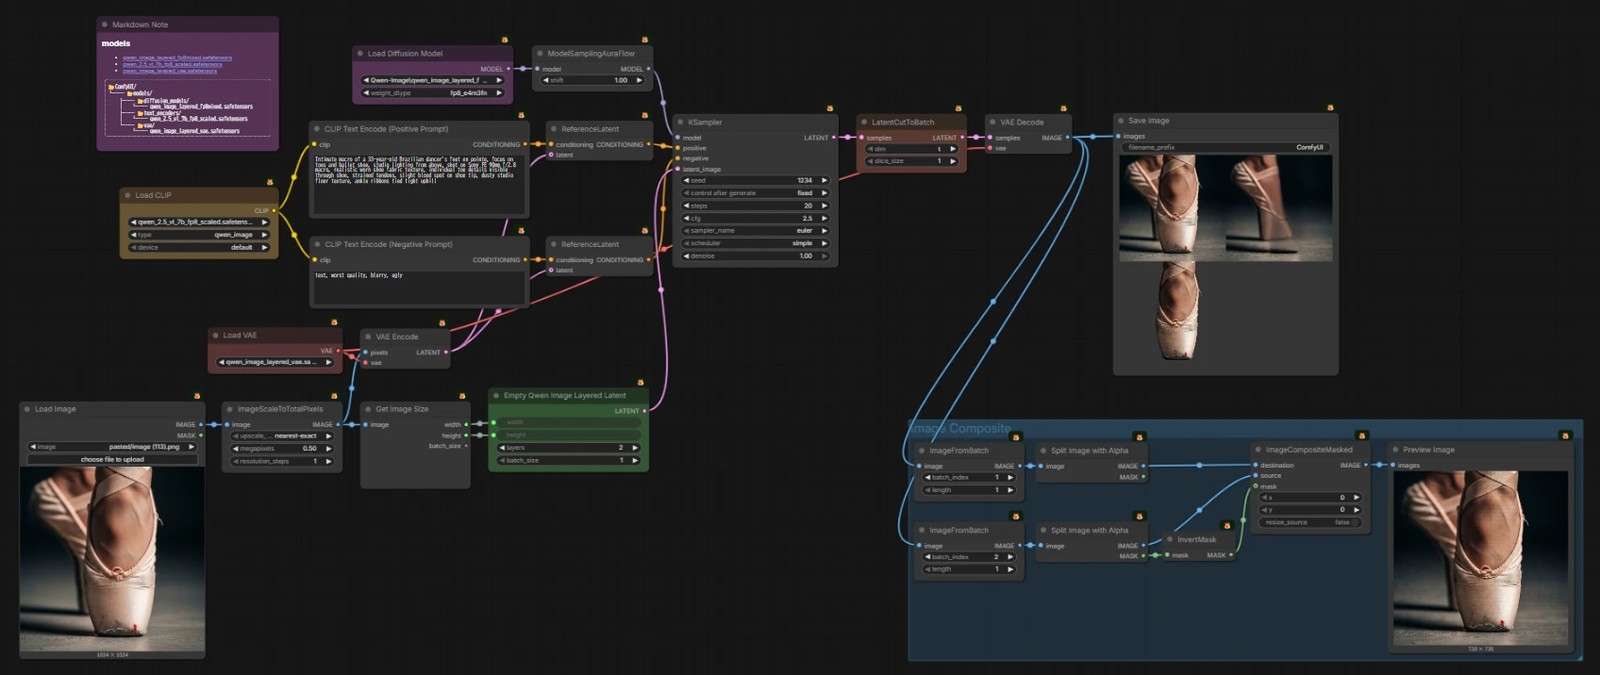
入力画像のリサイズ
- 1024px まで大きくできますが、レイヤー数が増えるほど重くなりやすいので、ここでは 0.5M ピクセルに設定しています。
-
🟩
Empty Qwen Image Layered Latentlayers: 分割したいレイヤー数- こちらも増やすほど、メモリと時間コストが上がります。
-
🟫
LatentCutToBatch- なにをやっているのか分かりづらいとは思いますが、実装都合の「整形」だと思ってしまってください。
- このモデルはその名の通り複数枚の画像を「レイヤー」として出力しますが、現在の
VAE Decodeはレイヤーという概念をうまく理解できないため、単なるN枚のバッチ画像に変換します。
-
🟦画像をまた合成する(任意)
- 2つのレイヤーに分けた場合、合計3枚の RGBA 画像(元画像+分解結果)が出力されます。
-
2枚目以降の画像を、
ImageCompositeMaskedで重ね続ければ元の1枚の画像に戻せます。- ただし、このノードはRGB画像しか扱えないため、RGB画像 + マスクという形に変換する必要があります。
- cf. マスクとアルファチャンネル
-
面倒くさいと思いますが、ComfyUIに限らず、ノードベースUIとレイヤーシステムは相性が悪いです😥