着せ替えとは?
ID転送が「人に特化したSubject転送」だとしたら、着せ替えは 「服に特化したSubject転送」 と言ってよいでしょう。
バーチャル試着(Virtual try-on / VTON) とも呼ばれます。
特に商品画像として使う場合には、
- 模様やディテールが変わらないこと
- 体型やポーズに自然にフィットしていること
といった一貫性が重要になります。
LoRA
なんでもですが、もっとも確実で柔軟性のある方法は、服のLoRAを作ってしまうことです。
inpaintingと組み合わせれば、特定の人物の服を着せ替えすることができます。
catvton-flux
VTON系タスク(服の着せ替え)に特化したモデルはいくつもありますが、代表例としてcatvton-fluxを挙げておきます。
基本的な考え方はIC-LoRA / ACE++と同じで、横並べレイアウトを使います。
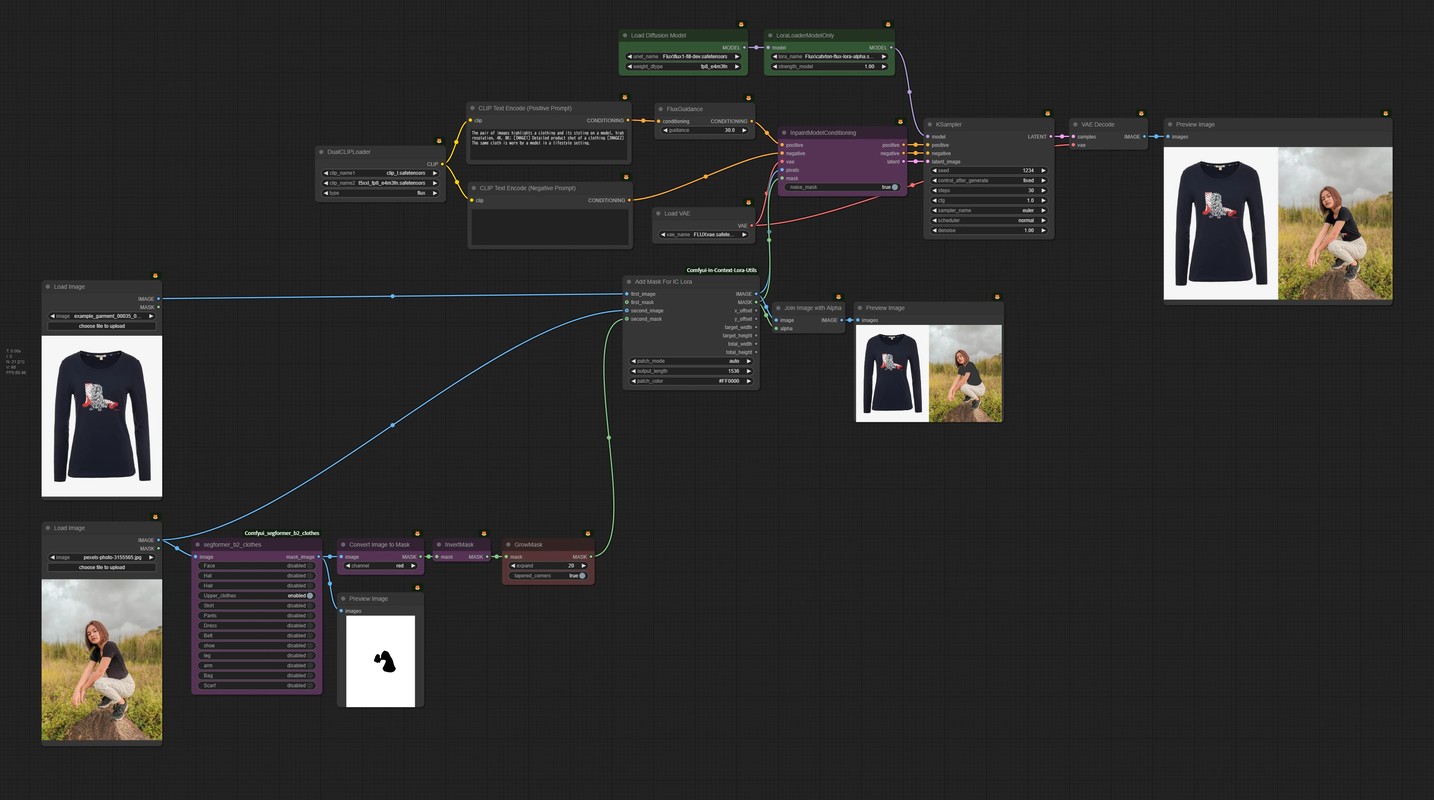
- 左側:人物画像
- 右側:着せたい服の画像 + マスク
モデルは両方を見ながら、「左の人物が右の服を着た画像」を生成します。
指示ベース画像編集(横並べ)
マルチリファレンスに対応していない指示ベース画像編集モデルは、本来「画像Aの要素を画像Bに持っていく」といったことはできません。
ただし、IC-LoRA / ACE++のときと同様に横並べテクニック とこのために学習したLoRAを使えば、近いことができます。
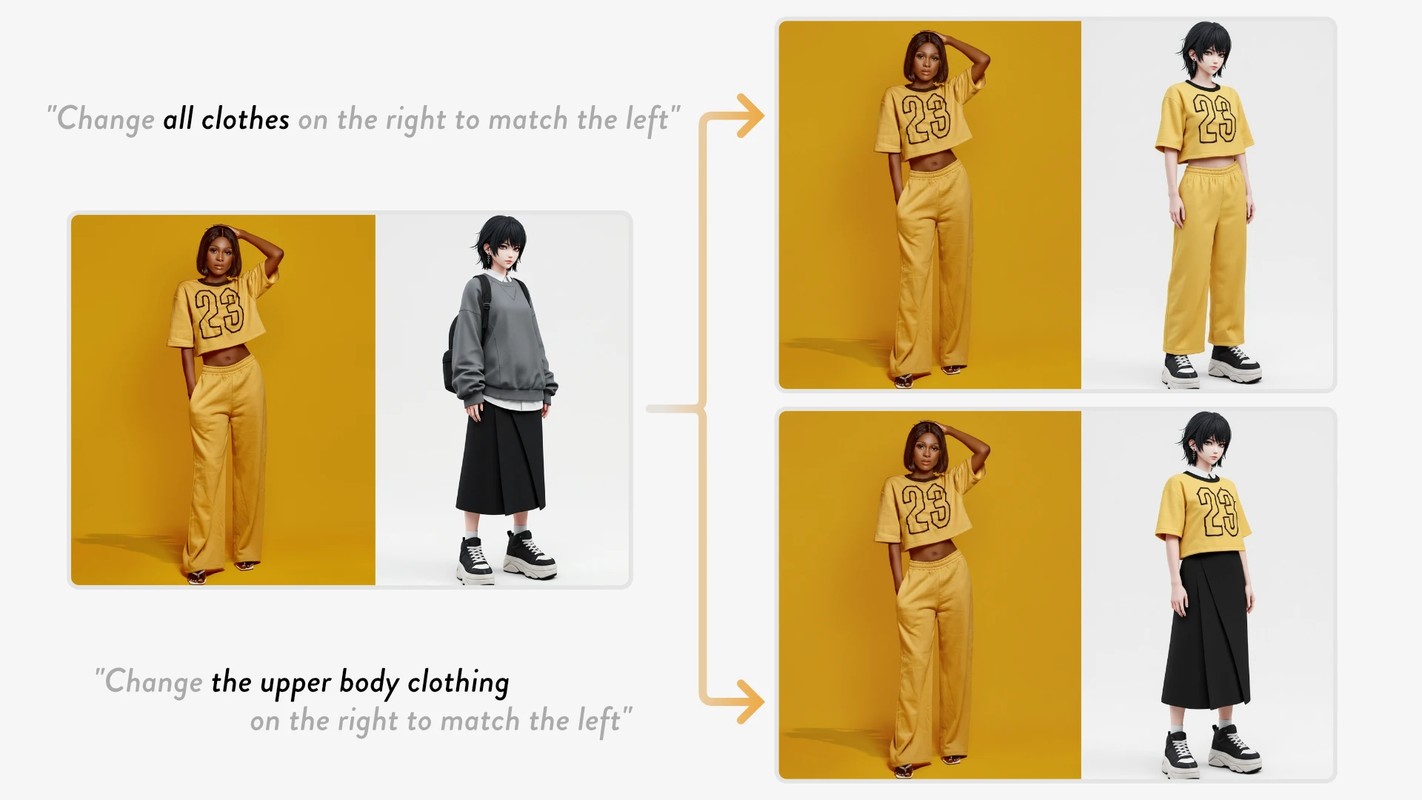
- nomadoor/crossimage-tryon-fluxkontext
- 左側:人物画像
- 右側:着せたい服の画像 + マスク
モデルは両方を見ながら、「左の人物が右の服を着た画像」を生成します。
自慢がしたかったため私が作ったLoRAを参考に出しましたが、その1日後に遥かに性能の高いQwen-Image-Edit用LoRAが発表されました☹️
Clothes Try On (Clothing Transfer) - Qwen Edit
指示ベース画像編集を使うことの最大のメリットは マスクが不要 になることです。
たとえば、ミニスカートの人物にジーパンを着せたい場合、通常のVTONではミニスカート部分だけでなく、ジーパンになる脚の部分も含めてマスクにしないといけません。
この2つを合わせた領域のマスクを自動生成することは非常に難しいのです。
それに対して、指示ベース画像編集はマスクが不要なため、そうした面倒なことを気にせず着せ替えができます。
指示ベース画像編集(マルチリファレンス)
マルチリファレンスに対応した指示ベース画像編集モデルなら、もう簡単です。
着せ替えたい人物と服装をそれぞれ別スロットに渡し、「この人物に、この服を着せて」といった指示を与えるだけで、着せ替えをすることができます。