AIを使ったマスク生成
inpainting などでマスクを作る場面は多いですが、毎回手書きをしたり、マスク画像を用意するのは大変です。なにより自動化できません。
しかし、単に「この部分をマスクして」と言うだけで、簡単にキレイなマスクが作れる技術は、あんまりありません。
いくつかの AI 技術を組み合わせて考える必要があります。
- 物体検出 - 画像内の対象がどこにあるかを見つけます。
- セグメンテーション - 対象の形をマスクとして切り出します。
- マッティング - 前景と背景の境界を、より細かく扱います。
たとえば「対象を見つけるために物体検出を使い、その結果をセグメンテーションに渡してマスク化する」といった流れですね。
どんなものがあるか、見てみましょう。
物体検出 (Detection)

その名の通り、画像内にある特定の物体の位置を特定することができ、BBOXと呼ばれる四角い範囲を出力します。
YOLO系
リアルタイムに物体を検出することを目的としている、超高速な検出技術です。
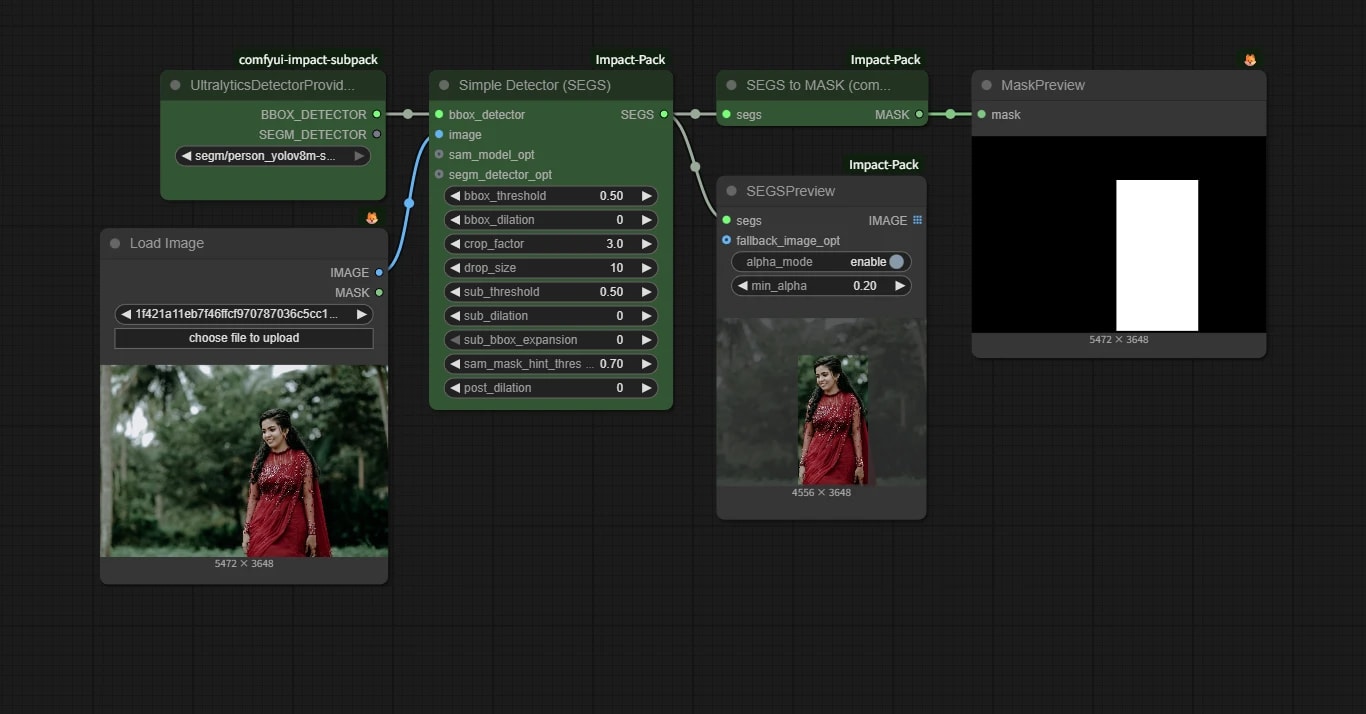
基本的には、検出したい物体の種類に対して一つのモデル(顔専用、手専用など)を作るため、モデルがなければ自分で作る必要がありますし、複数の種類を検出したい場合には不向きです。
その分、処理が非常に軽いので、高速処理が必要な場合に適しています。
Grounding DINO 他
テキストで指定した物体を検出し、BBOXを出力します。
YOLOとは違い、「white dog」「red car」など好きなテキストで物体を指定できるため使い勝手が良く、同時に複数の物体を検出することもできます。
VLM / MLLM
画像を見る能力を持った LLM が、VLM / MLLM です。
キャプション生成など様々なことができますが、その中の一つに物体検出ができるものがあります。
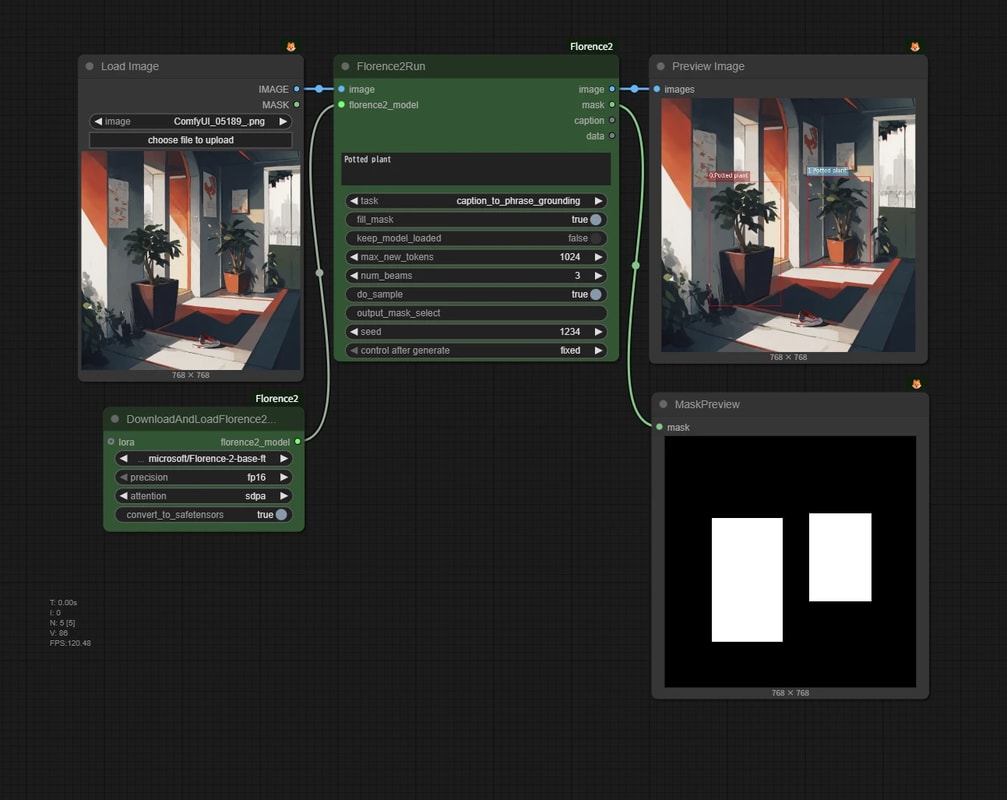
かなり古いですが、代表的なものには Florence-2 のようなものがあります。
速度は遅いですが、理解力が高いため「画面右側に映っている青い帽子を被った女性」のように、複雑な文章で対象を指定できます。
マッティング (Matting)
「背景除去」と呼ばれる処理の多くは、マッティングです。
手前にあるものと背景を分け、髪の毛のような細かい境界や半透明の部分も扱えます。
ただし、セグメンテーションのように特定の物体を指定して抜くものではありません。
BiRefNet
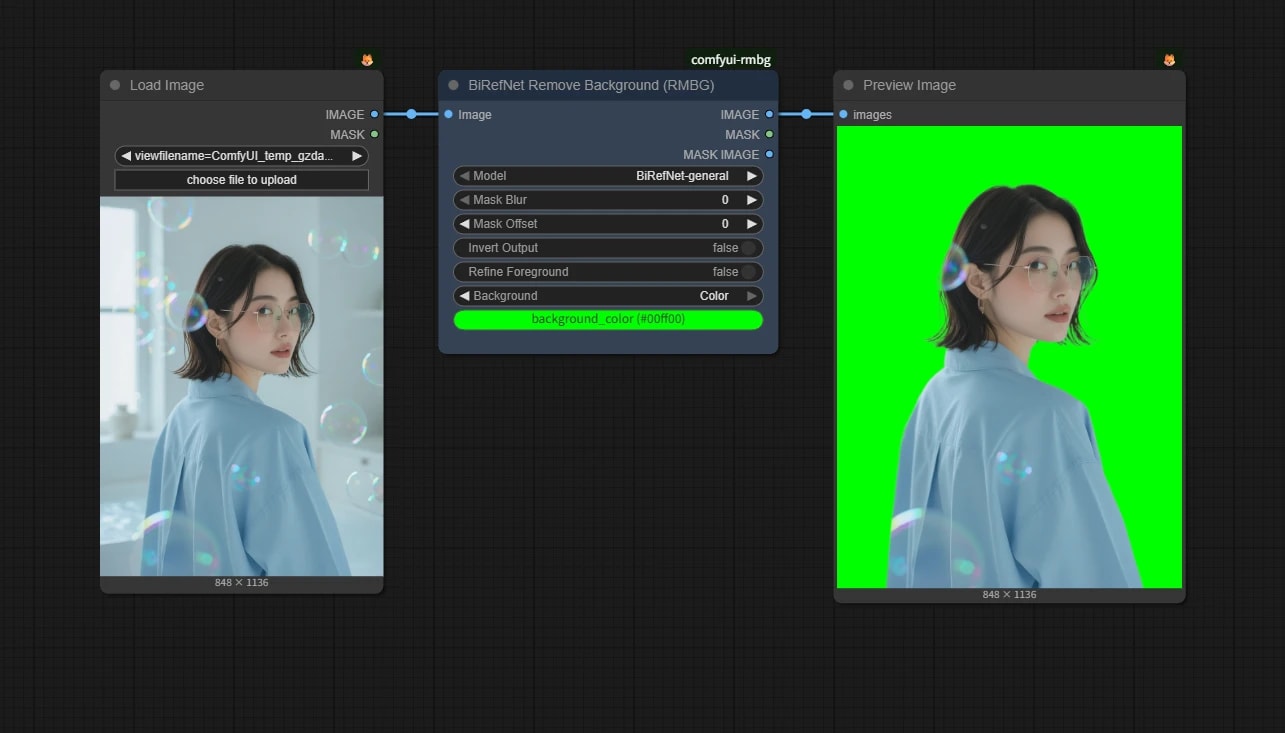
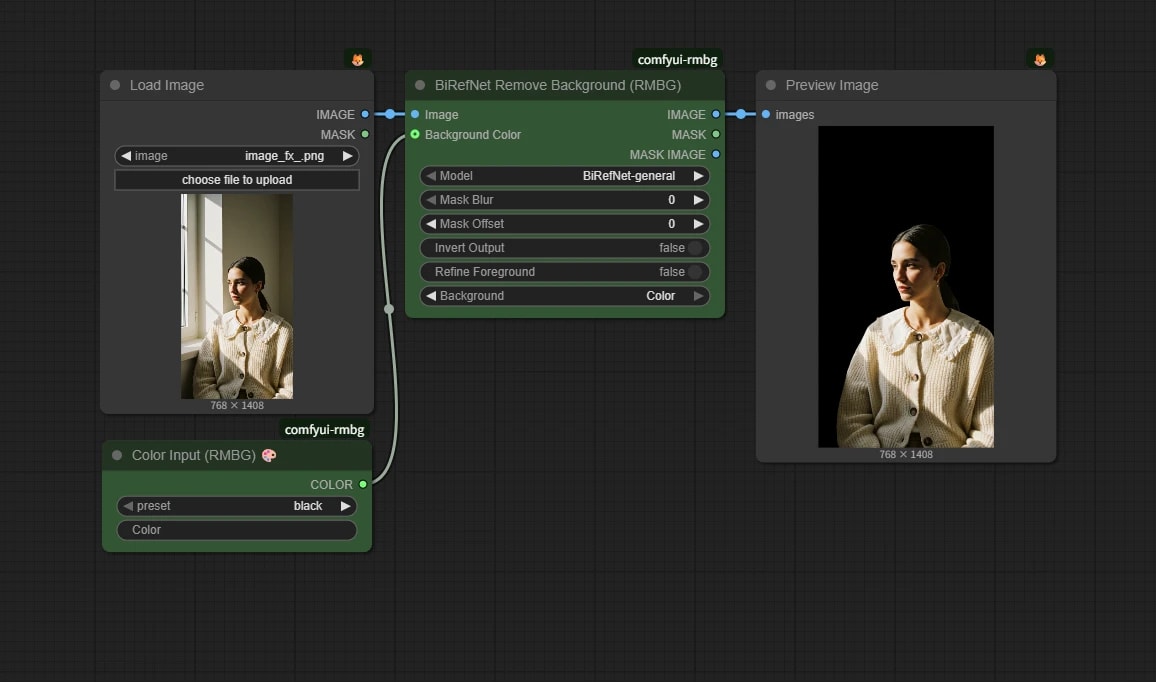
詳しい使い方は BiRefNet のページで扱っています。
セグメンテーション (Segmentation)
SAM (Segment Anything Model)
現在最も有名なセグメンテーションモデルです。
「物の形」を理解しているため、写真内の車などをテキスト、ポイント、ボックスで指定すると、その輪郭を見つけてマスクにしてくれます。
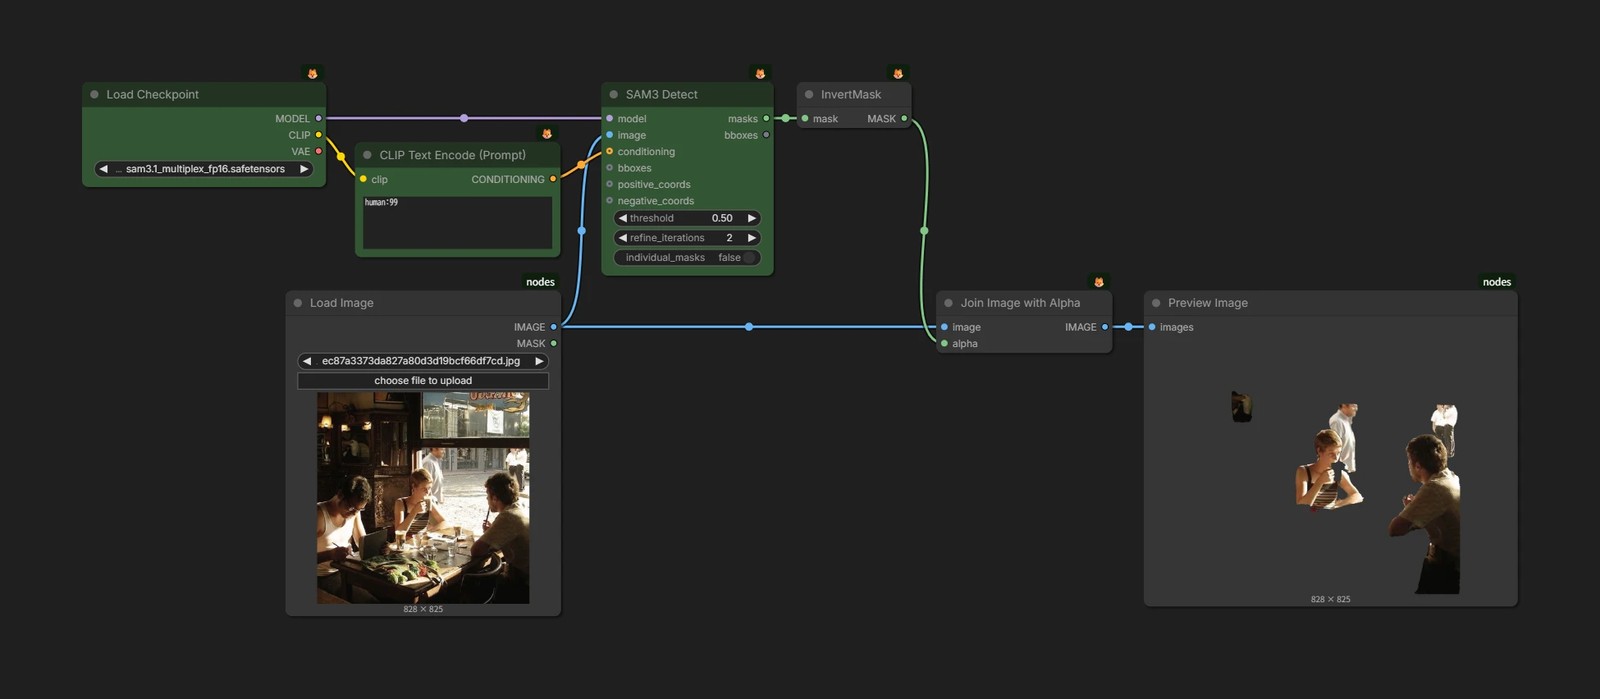
現在の最新モデルである SAM 3 / 3.1 のページで扱っています。
実践例
上記の技術を組み合わせて、任意のテキストやカテゴリのマスクを生成してみましょう。
以下の workflow は SAM 3 登場以前によく使われていた構成です。対象指定のセグメンテーションが目的なら、現在はまず SAM 3 / 3.1 を試してください。
古い workflow を読み解きたい場合や、既存環境で同じ構成を再現したい場合の参考として残しています。
必要なカスタムノード
以下は、このページの実践例を動かすために必要になることがあるカスタムノードです。
- 1038lab/ComfyUI-RMBG
- 以前は、マッティングからセグメンテーションまで幅広く使われていました。
- 現在は ComfyUI core に BiRefNet 系の背景除去も入っているため、まず core 側を確認してください。
- ltdrdata/ComfyUI-Impact-Pack
- ltdrdata/ComfyUI-Impact-Subpack
- Detailer まわりで使われることが多いノード群です。単純なマスク生成だけに使うには少しクセがあります。
- kijai/ComfyUI-Florence2
- Florence2 という MLLM を動かします。
- kijai/ComfyUI-segment-anything-2
- SAM 2 / 2.1 系のセグメンテーションモデルを動かすために使います。
YOLO × SAM
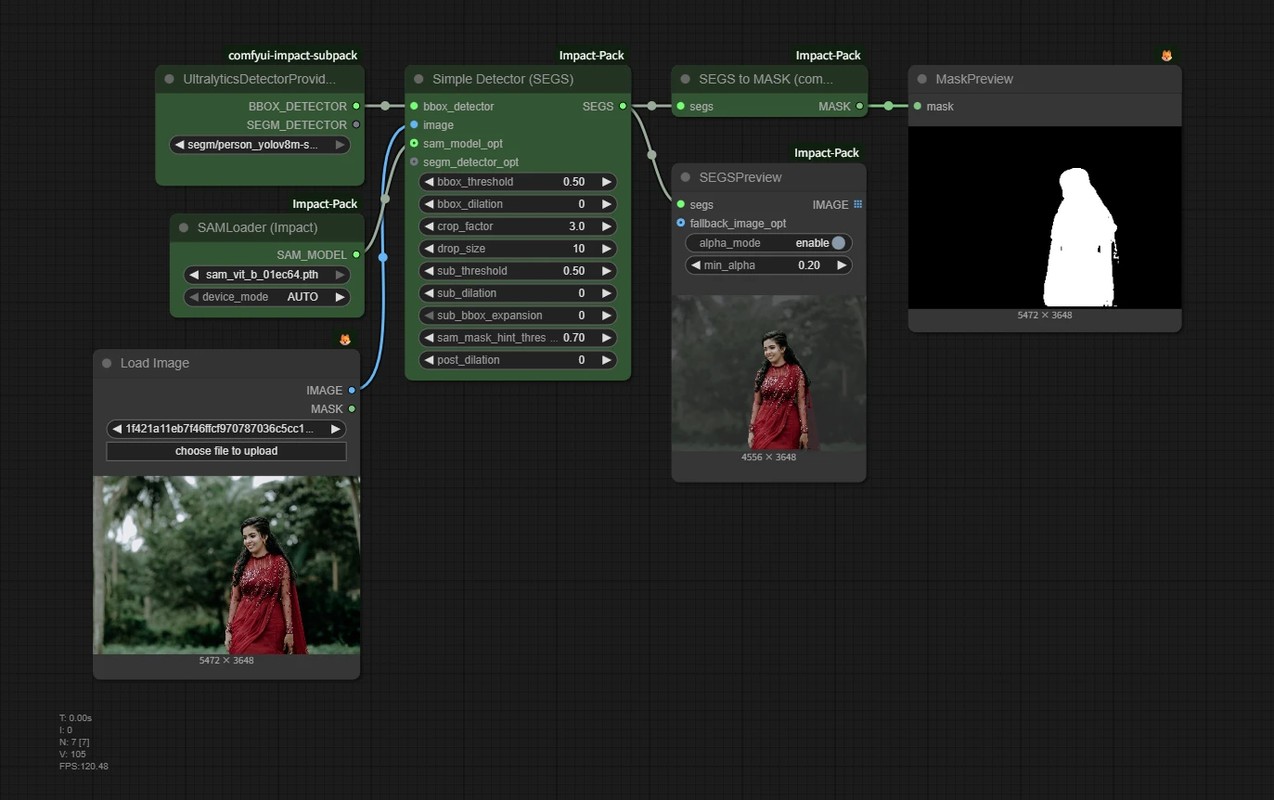
高速な顔検出(YOLO)と SAM(初期) の組み合わせです。
Grounding DINO × SAM
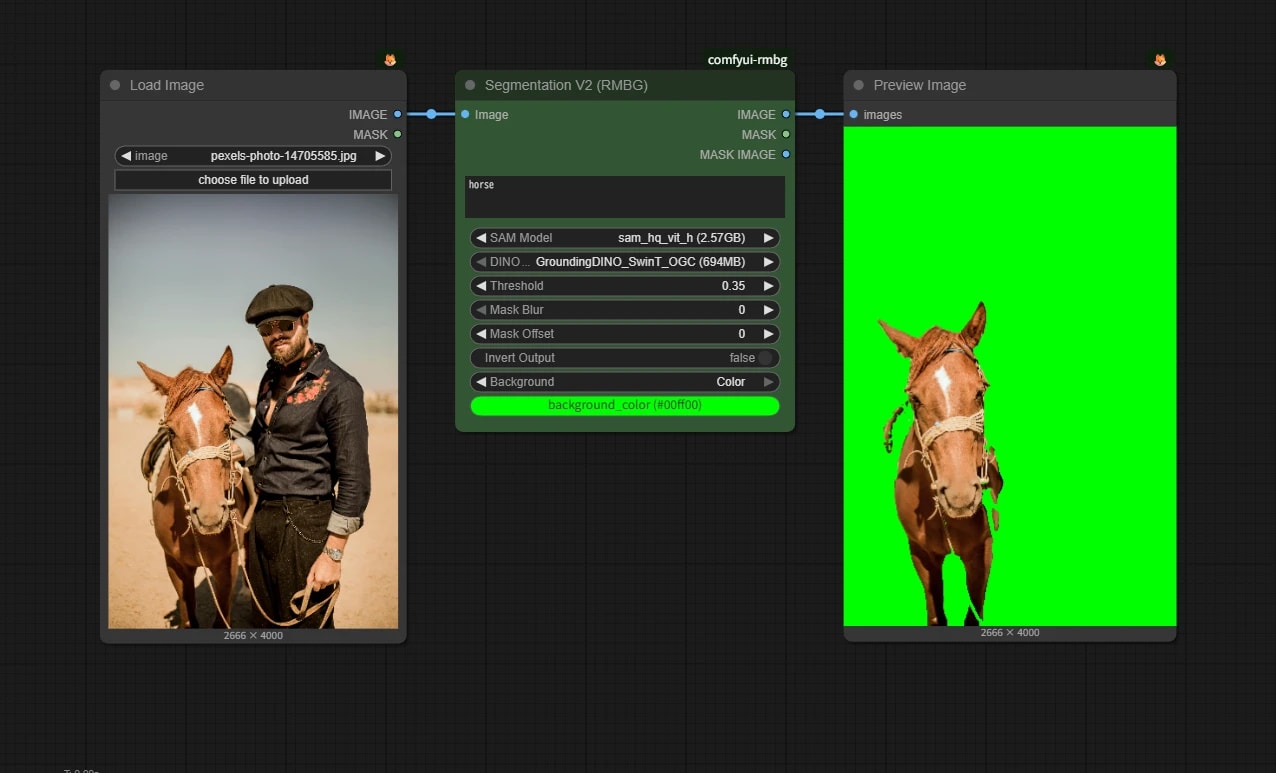
Grounding DINO と SAM の改良版である HQ-SAM の組み合わせです。
テキストで対象を指定しつつ、高精度なマスクを生成できるので、最も使われる組み合わせの一つです。
Florence2 × SAM2
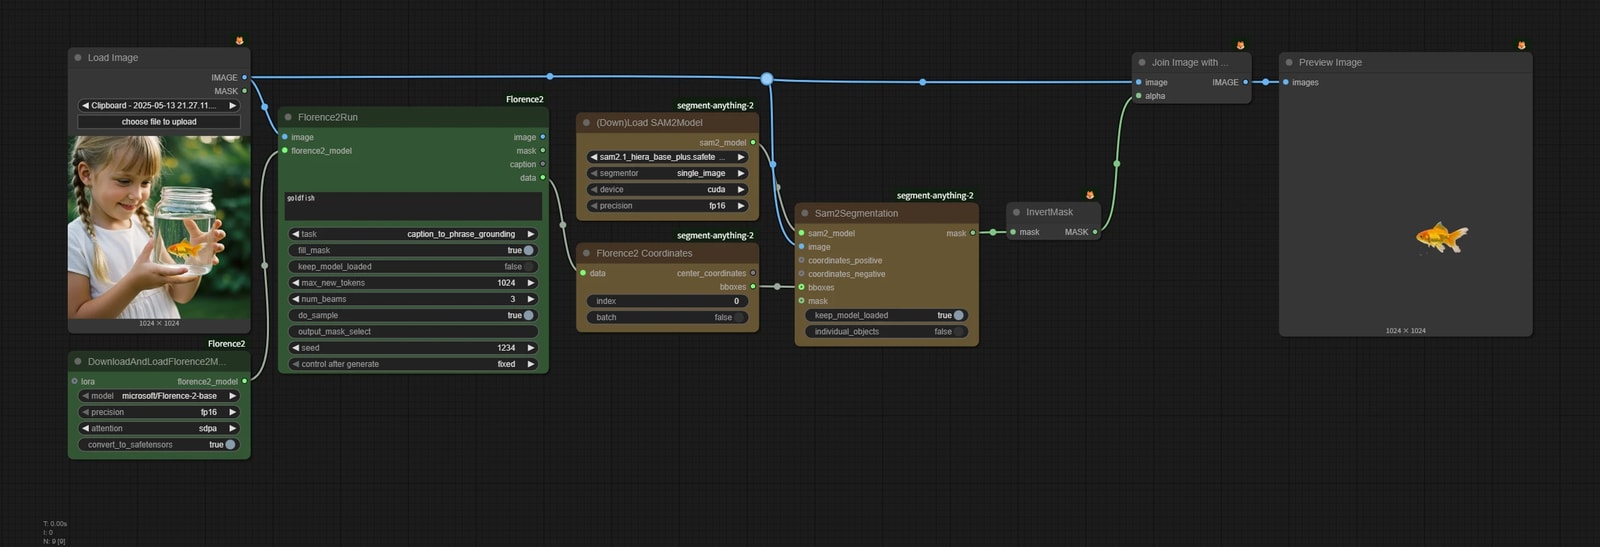
Florence2 と SAM2.1 の組み合わせです。
人や動物といった分かりやすい対象ならなんでも良いのですが、「サングラスをかけた男性」「木の下に寝転んだ猫」など複雑な条件で指定したいときは、このような LLM ベースのモデルが力を発揮します。
SAM 3 × BiRefNet
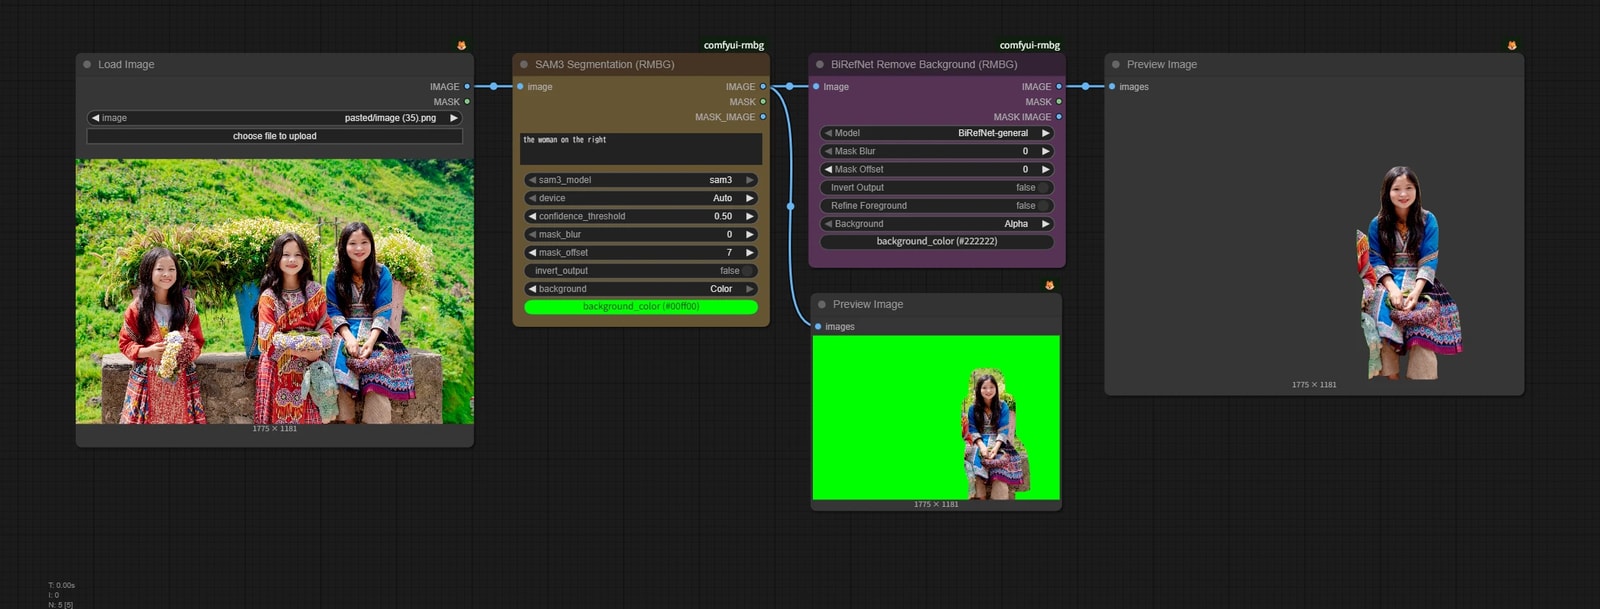
セグメンテーションはそもそもオブジェクトを区別するものであり、精細な切り抜きに使うものではありません。
対して、マッティングは髪の毛のような微細なものや、ガラスのような半透明なものも扱えます。
これらを組み合わせることでお互いの能力をかけ合わせることができます。