指示ベース画像編集とは?
画像とテキストの指示(必要なら参照画像も)を入力すると、その指示に従って画像を編集してくれるモデルを、このサイトでは 指示ベース画像編集モデル と呼びます。
以前は、
- 絵柄変換 → LoRA や IP-Adapter
- オブジェクト除去・置き換え → inpainting
- 着せ替え → 専用モデル
といった具合に、タスクごとに別々の技術や workflow を組む必要がありました。
指示ベース画像編集モデルは、こうしたタスクを 「全部テキスト指示でまとめて扱う」 方向に進化させたものです。
現在 SOTA である nano banana も、このカテゴリに入ります。
発展の歴史
指示ベース画像編集がどのように発展してきたか、大まかに流れを押さえておきましょう。
InstructPix2Pix ― 指示で編集する発想の出発点
2023 年に発表された InstructPix2Pix により、「指示ベース画像編集」という道が開かれました。

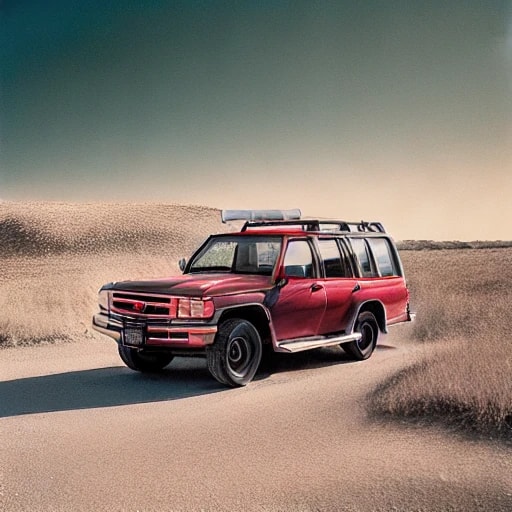
Turn the car red
このモデルは「画像」と「それに対する編集指示テキスト」をペアで学習し、ユーザーの書いた指示に従って画像を編集することを目指したモデルです。
DiT と In-Context 系
あとから発見されたことですが、Flux などの DiT 系モデルは、もともと 複数枚にわたって一貫性のある画像を作る能力 を持っていました。
この性質を編集に応用する枠組みが、IC-LoRA / ACE++ です。
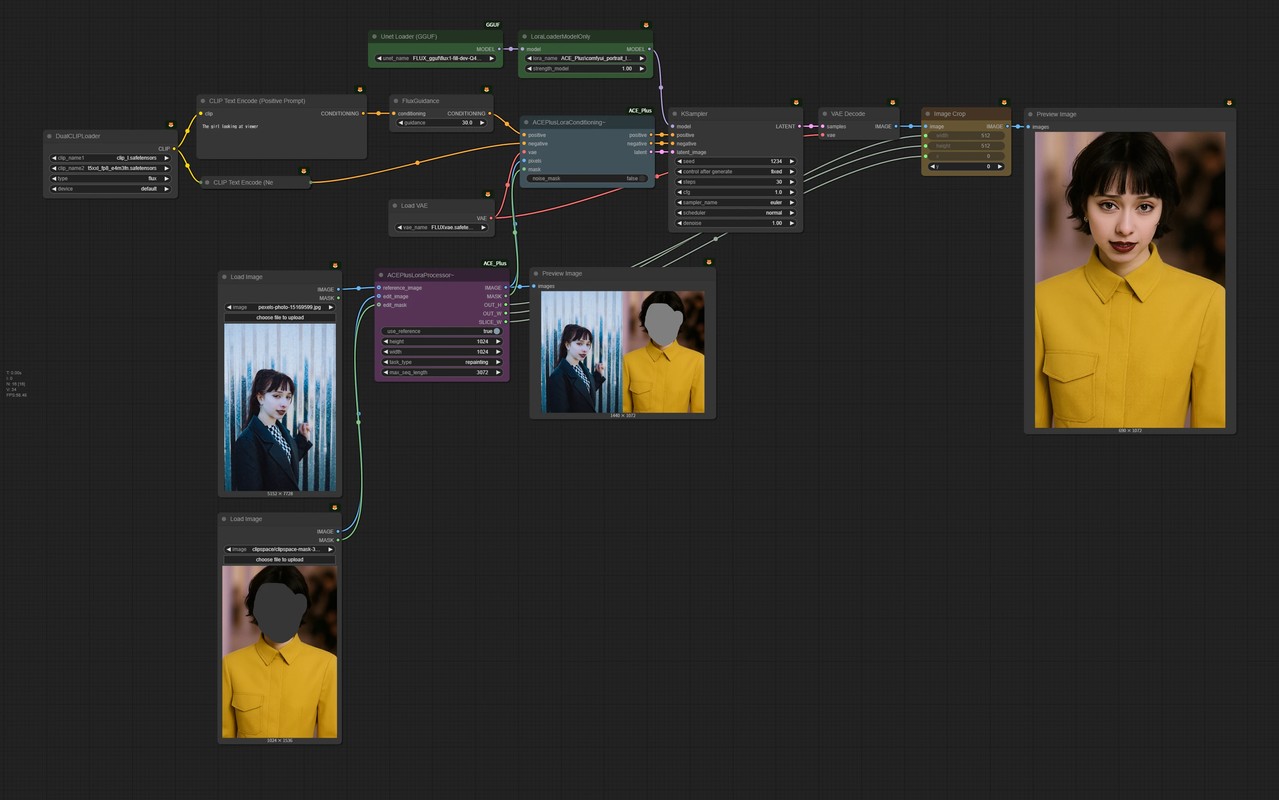
- 画像キャンバスの左側に「参照画像」を置く
- 右側をマスクして生成させる
- テキスト指示と組み合わせて「左側を見ながら右側を編集」させる
といった、いわゆる 横並べテクニック を使うことで、特別なアダプタを介さずとも「参照画像の特徴を保持したまま編集できる」ことが示されました。
画像編集モデルの登場
その後、text2image モデルの派生として、FLUX.1 Kontext、Qwen-Image-Edit、OmniGen といった「画像編集」専用のモデルが登場し、「画像編集」が text2image とは別の一カテゴリとして扱われるようになってきました。
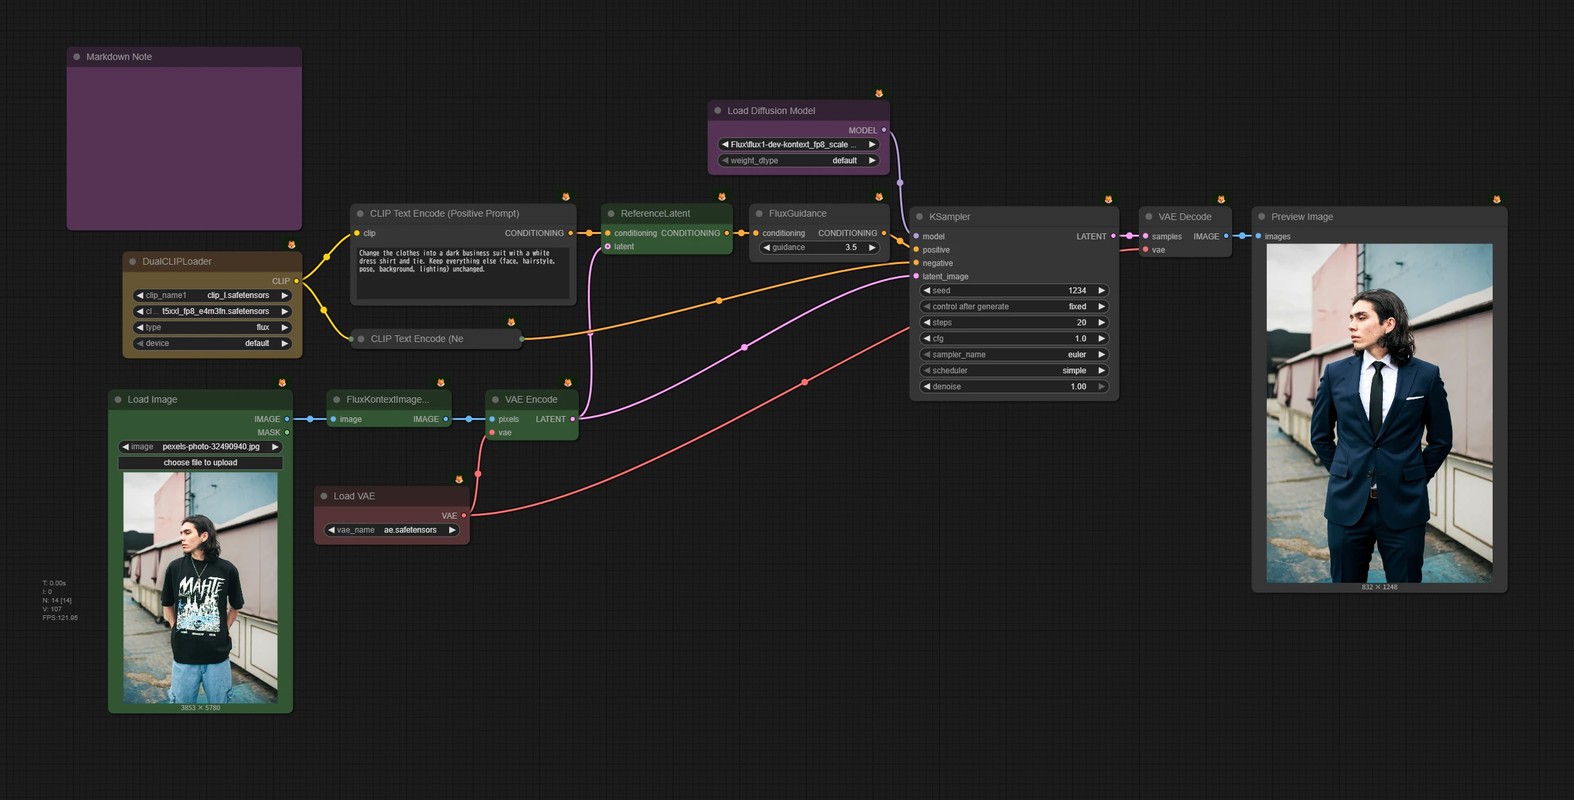
共通しているのは、入力画像の内容を理解し、テキスト指示に応じて「どこをどの程度変えるか」を調整する、といった編集タスクを、ひとつのモデルで(そこそこ)汎用に扱おうとしている点です。
マルチリファレンス時代
初期の指示ベース画像編集は、「画像 1 枚」+「テキスト指示」→ 編集結果という 1 入力画像前提でした。
Qwen-Image-Edit-2509 や Flux.2 以降は、複数の参照画像を同時に扱う流れが強くなっています。
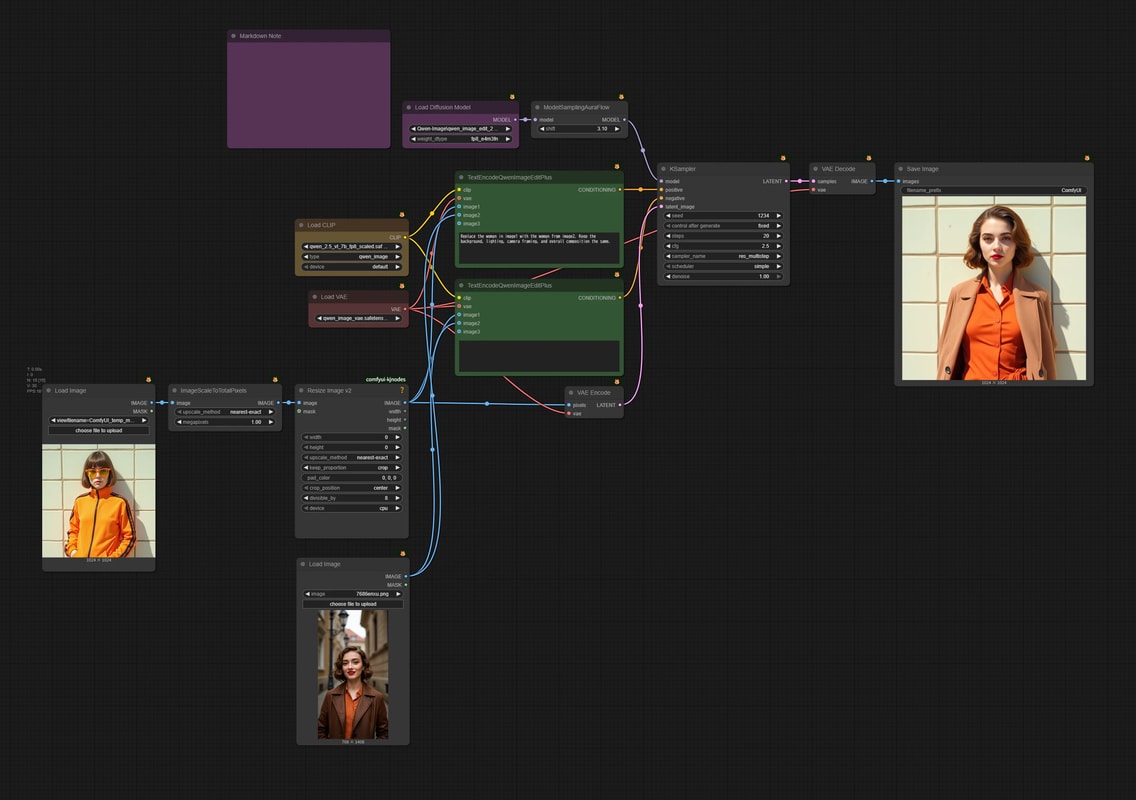
- 画像 A:人物(Subject)
- 画像 B:服(着せ替え用)
- 画像 C:背景やスタイル
のように、複数リファレンスを「混ぜながら」編集できるようになり、Subject 転送、ID 転送、着せ替え、スタイル・ライティングの移植といったタスクと、指示ベース編集がかなり重なり始めています。
動画モデルベースの編集
もうひとつの流れとして、動画生成モデルを編集に転用する系統があります。FramePack の 1 フレーム推論 や ChronoEdit などが代表的です。
考え方としては、動画モデルはそもそも「複数フレームの一貫性」を扱えるため、編集前と編集後を「短い動画」と見なしてしまえば、大きな変化も自然につなげられる、というものです。
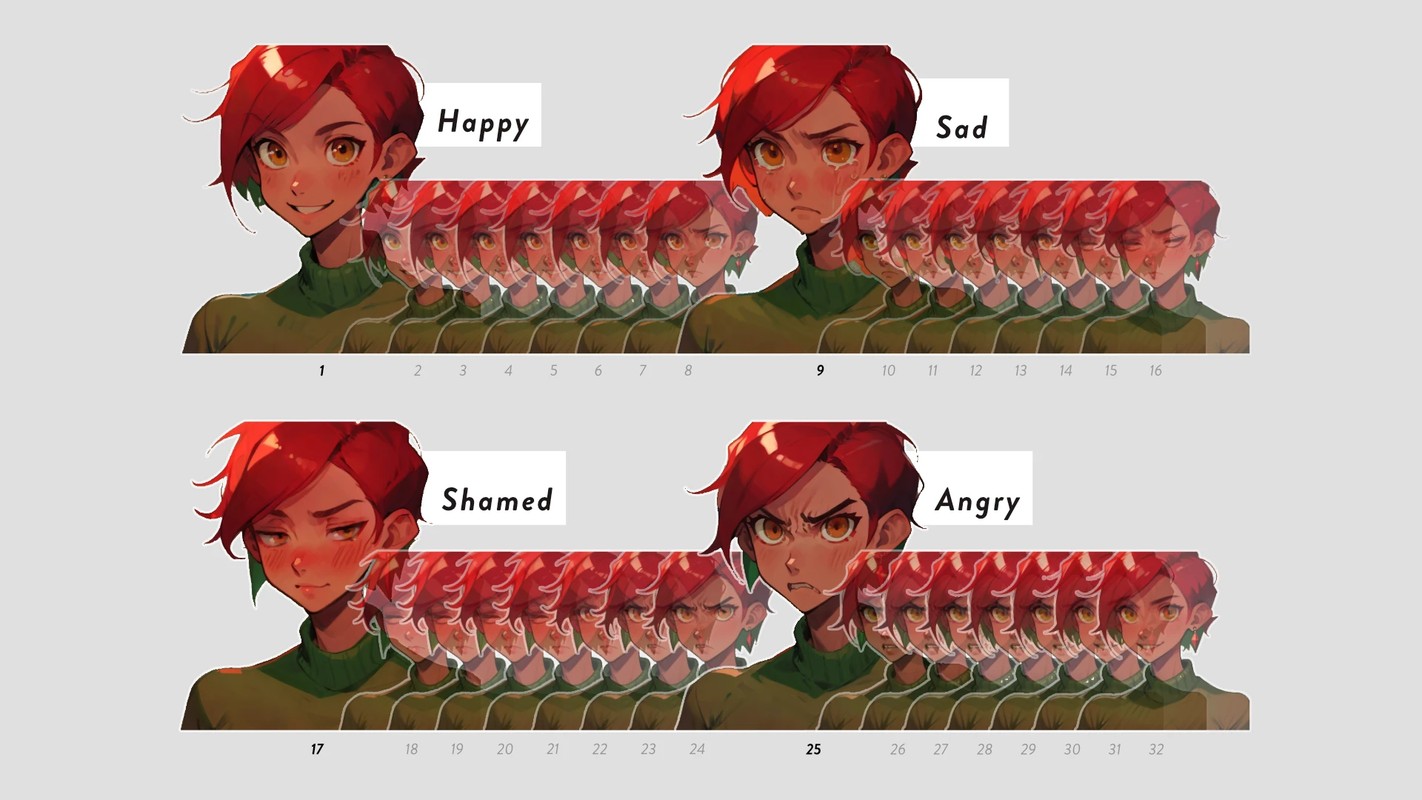
この考え自体は古くからあり、私も AnimateDiff が主流だった時代に、いろんな表情をするキャラのアニメーションを作成し、キャラ差分を作る、といったことをしていました。
一貫性が強すぎて大きな変化をさせることが難しかったり、画像編集としては 1 枚しかいらないのに、動画として何十フレームも出力してしまうなど、まだ問題も多いですが、今後注目すべき技術だと思います。
指示ベース画像編集でできること
指示ベース画像編集モデルで扱えるタスクはかなり多いですが、このサイトでは個別のページで詳細を扱うので、ここではざっと名前だけを整理しておきます。
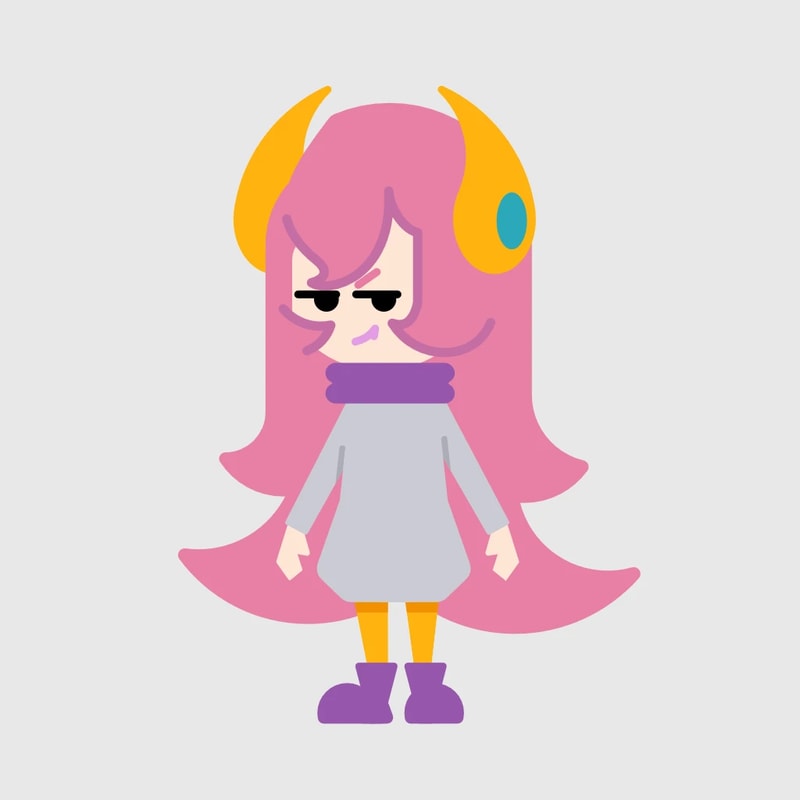
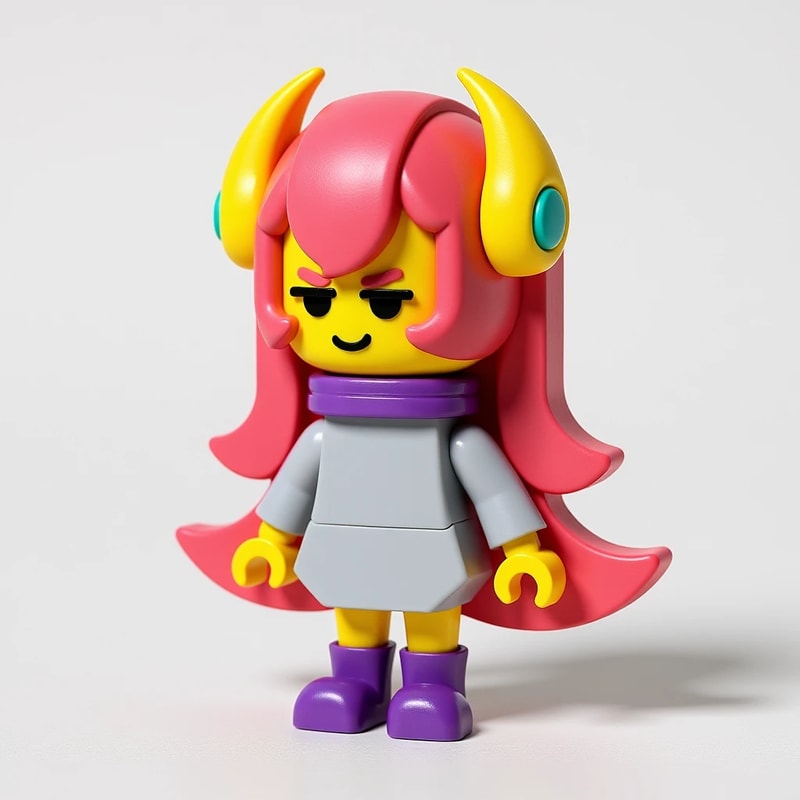
絵柄変換
画風やテイストを変えたり、「油絵風」「アニメ調に」などの変換を行います。
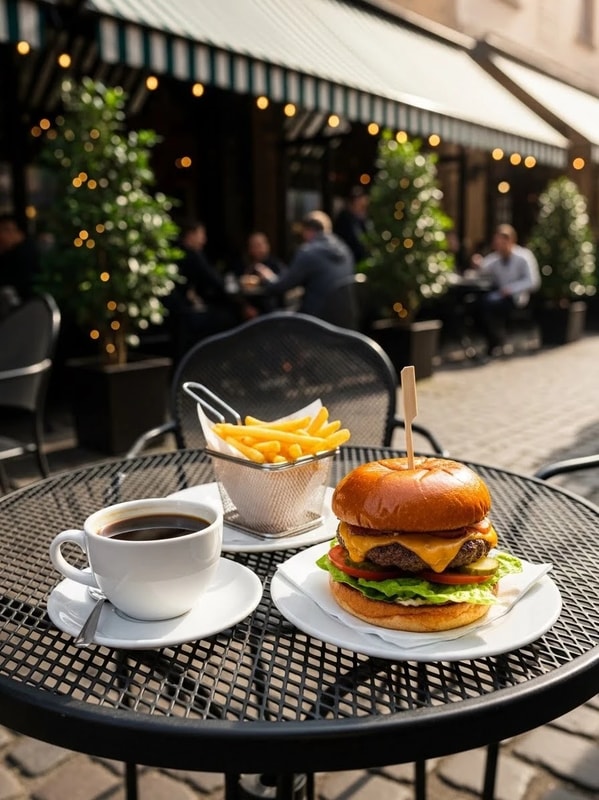
オブジェクト入れ替え
「このカップをマグカップに」「車をバイクに」などの差し替えを行います。
オブジェクト除去
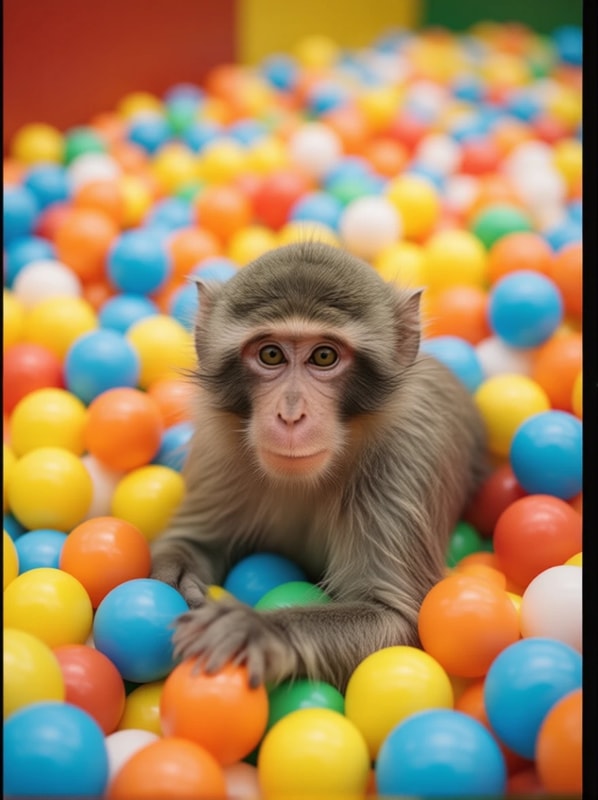
通行人や看板、ゴミなど「不要なもの」を消すタスクです。
背景変更
室内→海辺、昼→夜など、背景だけを変える編集です。
テキスト編集
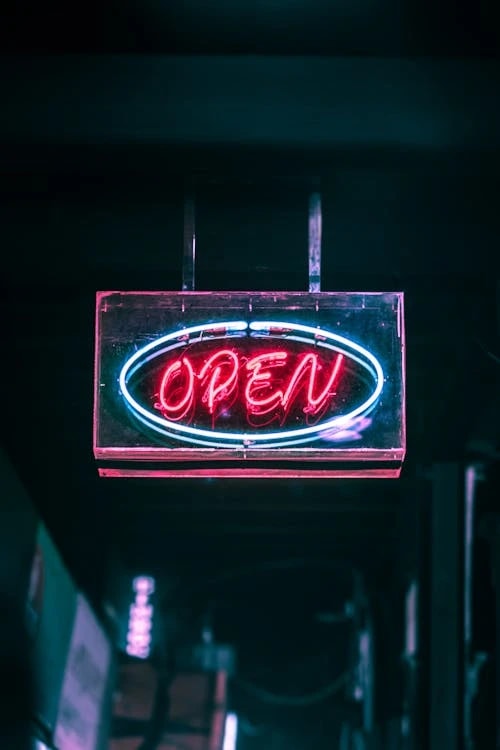
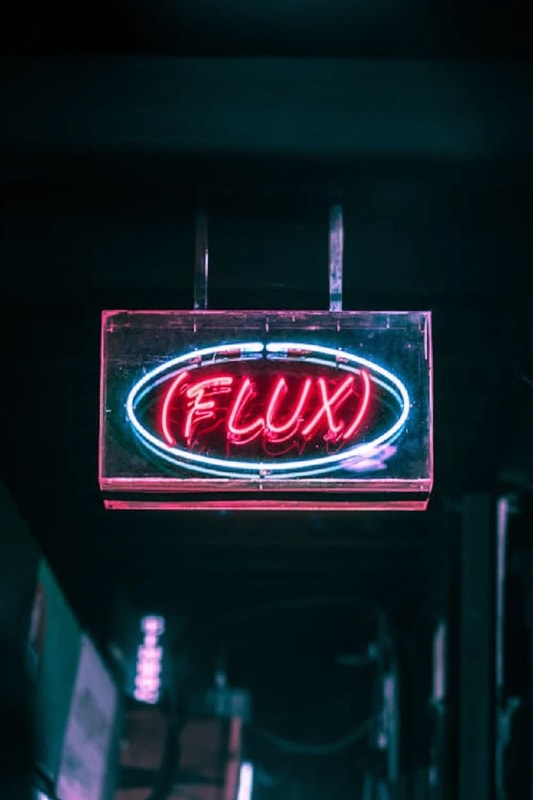
看板やパッケージの文字を変える、タイポグラフィを入れ替えるなどを行います。
カメラアングルの変更
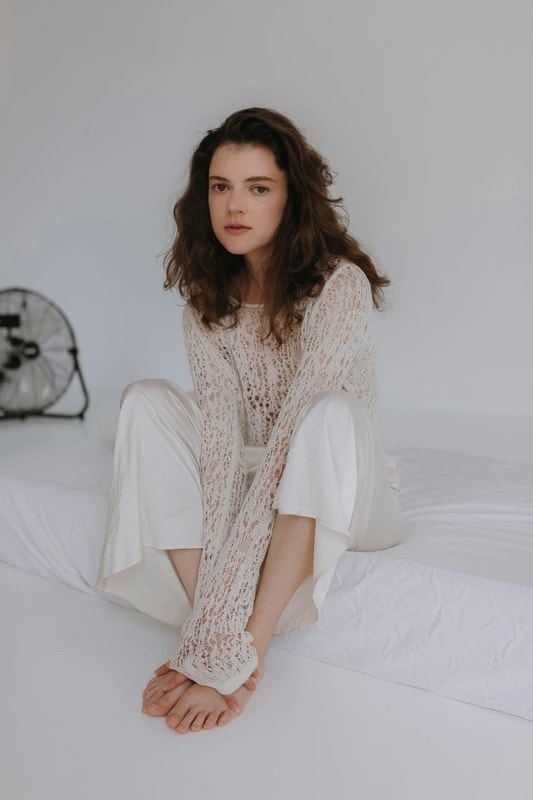
「少し引きで」「ローアングルで」「横から見た構図で」など、構図寄りの変更を行います。
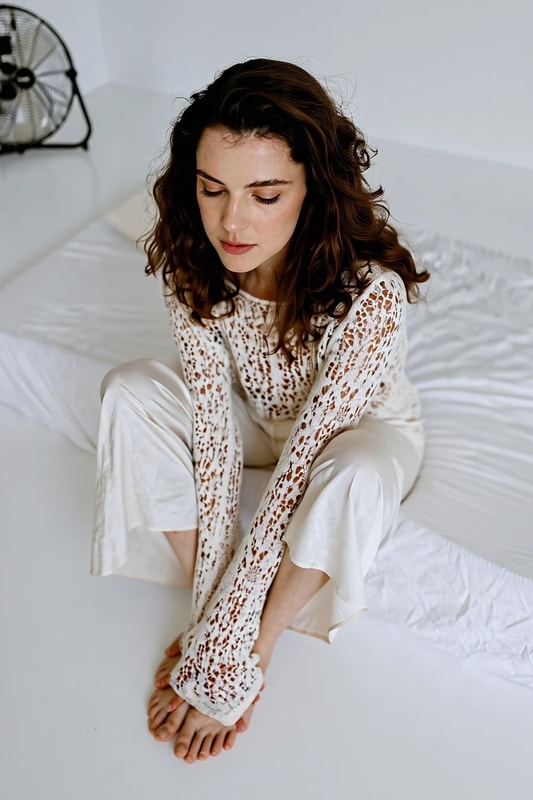
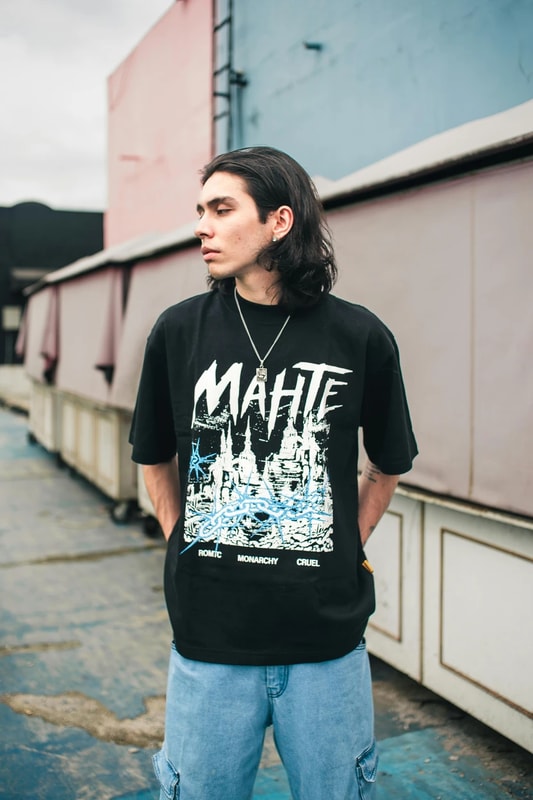
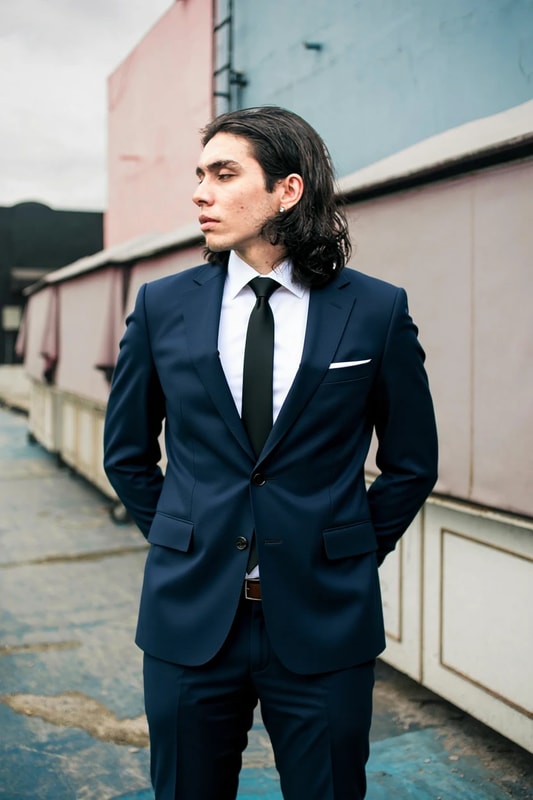
着せ替え
人物やキャラの服装を変えるタスクです。
ControlNet 的生成
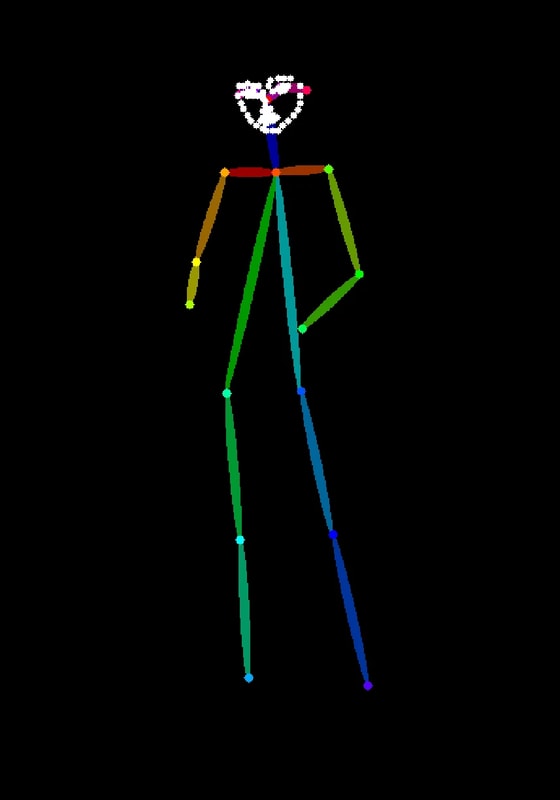
ControlNetは棒人間や深度マップといった条件 + テキストで画像生成するものでしたが、これは一種の「指示ベース画像編集」とみなせます。
現在の指示ベース画像編集モデルは基本的なControlNet的画像生成を行えるように学習されています。
雑コラのリファイン
コラージュ画像(雑コラ)を作り、それを自然に見えるように「編集させる」タスクです。
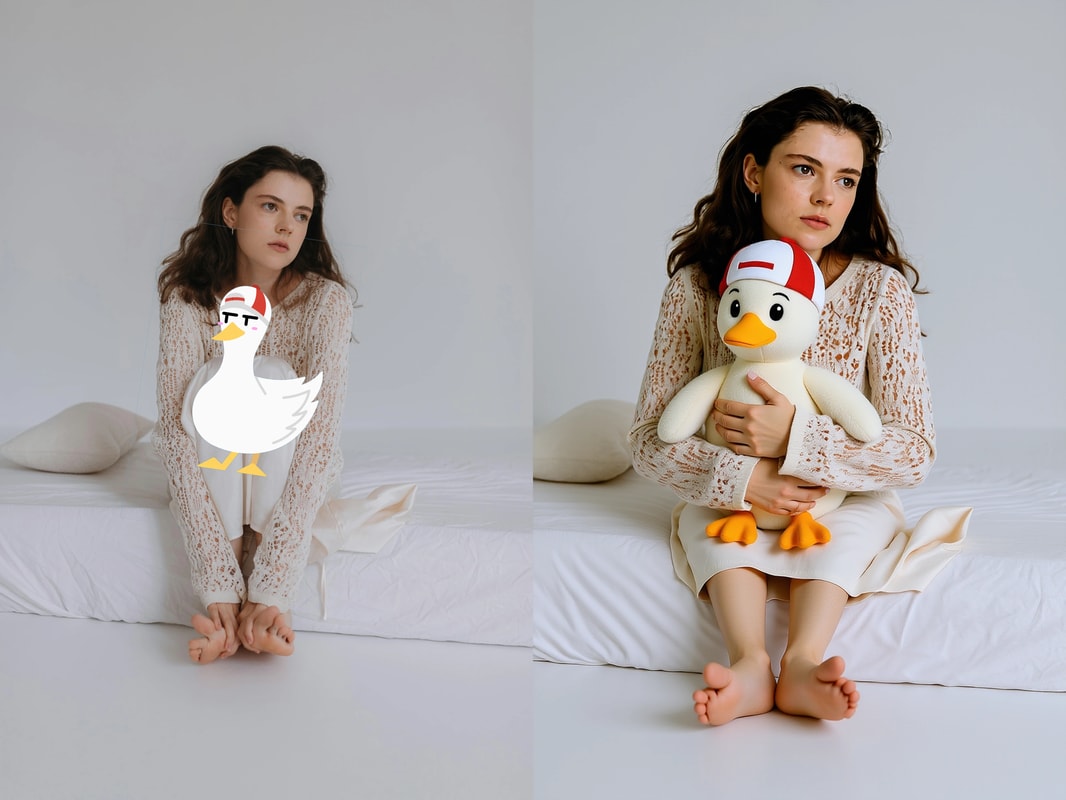
- 自分で位置・大きさを決めてオブジェクトを貼り付ける
- その上で「自然な写真にして」「一枚絵として違和感がないように」と指示する
といった形で、直感的なレイアウト指定と指示ベース編集を組み合わせることができます。
詳しくは「雑コラのリファイン」のページで扱います。
落書きでの指示
「矢印の方向に顔も向かせて」「この赤丸の場所にバスを置いて」など、ラフな描き込みとテキストを組み合わせて指示を行います。
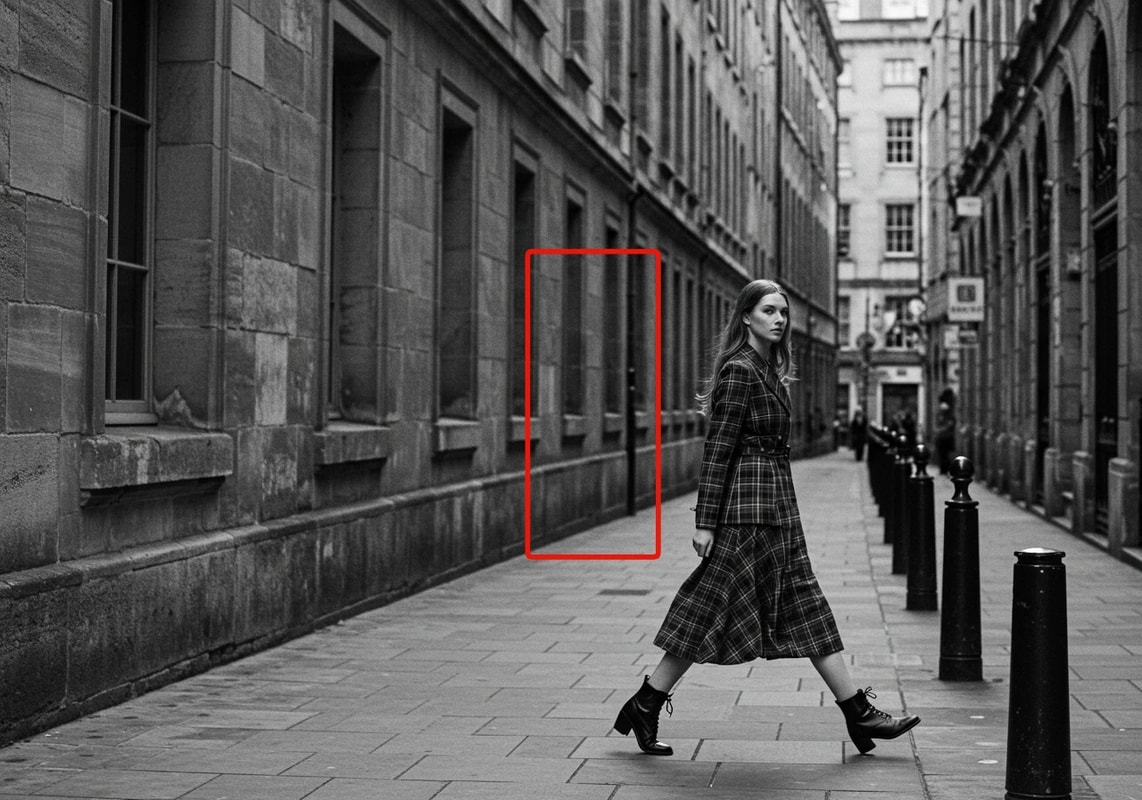
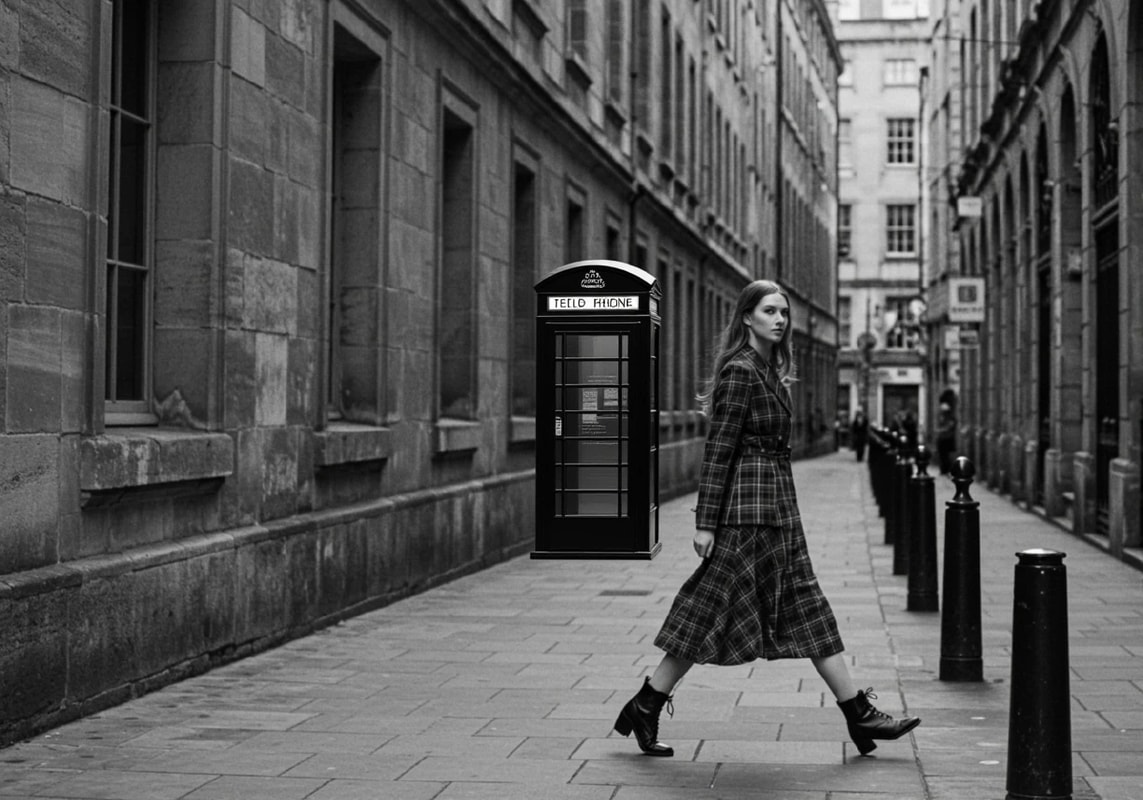
指示ベース画像編集の弱点は、テキストだけでは具体的な位置や変化量を表現しづらいことです。
プロデューサーがデザイナーにペンで指示をするように、AI に対しても「ペンで指示できる」ようになれば理想的です。
オープンソースモデルでこれを十分に行えるものはまだ多くありませんが、完成すれば理想的な AI との協業 UI/UX になるでしょう。
LoRA を作りやすい
学習環境を整えてくれているコミュニティのおかげで、比較的簡単に編集用 LoRA を作ることができます。
自分のイラストの絵柄に変換させるようなLoRAなら、編集前画像と編集後画像のペアを10枚ほど用意すれば、ある程度のクオリティのLoRAができます。
「雑コラのリファイン」なんかはまさにそうですが、なにを「画像編集」とみなすか?は実のところかなり自由度の高い問いです。
まだ見つかっていない革新的な編集があるかもしれません。ぜひチャレンジしてみてください!