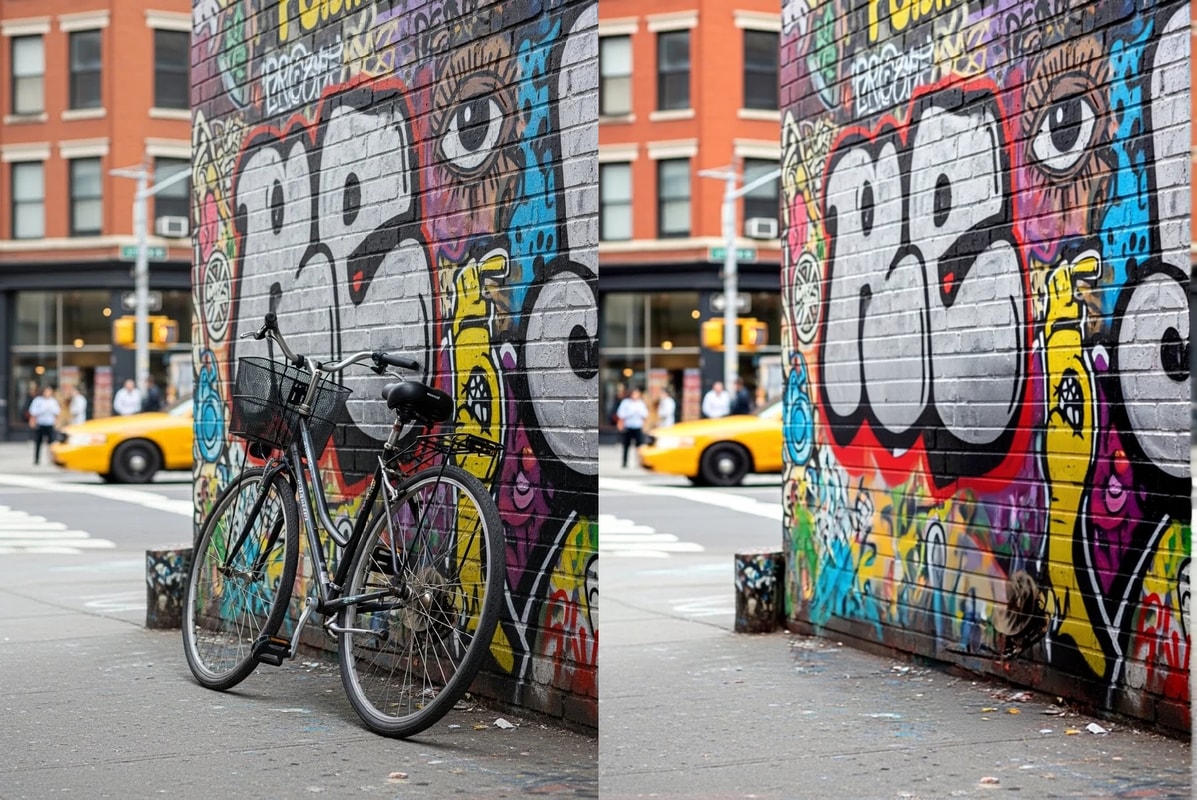
Qwen-Image-Editとは?
Qwen-Image-Edit は、Qwen-Image をベースにした 指示ベース画像編集モデル です。
ざっくりいうと、Flux.1 Kontext の Qwen-Image 版 という認識でよいと思います。
Flux.1 Kontext は VAE ベースの編集のみでしたが、Qwen-Image-Edit は MLLM を使って実際に参照画像を「見る」ことができるため、そのぶん柔軟な編集ができます。
その後しばらくして、マルチリファレンスに対応した Qwen-Image-Edit-2509 というモデルが発表されました。
これまでは「1枚の画像を編集する」だけでしたが、Qwen-Image-Edit-2509 では
- 「画像1 の人物の服装を、画像2 のものに変更して」
- 「画像1 と 画像2 が同じステージに立っている画像を生成して」
といったことができるようになります。
学習方法が異なるため、必ずしも 2509 が無印版の上位互換というわけではありませんが、迷ったときは 2509 を使っておけばよいでしょう。
Qwen-Image-Edit(無印)
何ができるかについては 公式 GitHub、または Flux.1 Kontext / できること も参考になると思います。
モデルのダウンロード
-
diffusion_models
-
text_encoders
-
vae
-
gguf(任意)
-
QuantStack/Qwen-Image-Edit-GGUF
- Q4_K_M 以上のモデルを選んでください。これ未満だと一気に性能が落ちます。
- cf. Qwen-Image-Edit GGUFモデル比較
-
Qwen2.5-VL-7B-Instruct-mmproj-BF16.gguf
- gguf を使う場合は、この mmproj ファイルが必須です。
-
📂ComfyUI/
└── 📂models/
    ├── 📂diffusion_models/
    │   └── qwen_image_edit_fp8_e4m3fn.safetensors
    ├── 📂text_encoders/
    │   ├── qwen_2.5_vl_7b_fp8_scaled.safetensors
    │   ├── Qwen2.5-VL-7B-Instruct.gguf                ← gguf を使う場合のみ
    │   └── Qwen2.5-VL-7B-Instruct-mmproj-BF16.gguf    ← gguf を使う場合のみ
    ├── 📂vae/
    │   └── qwen_image_vae.safetensors
    └── 📂unet/
        └── qwen-image-edit.gguf                       ← gguf を使う場合のみ
workflow
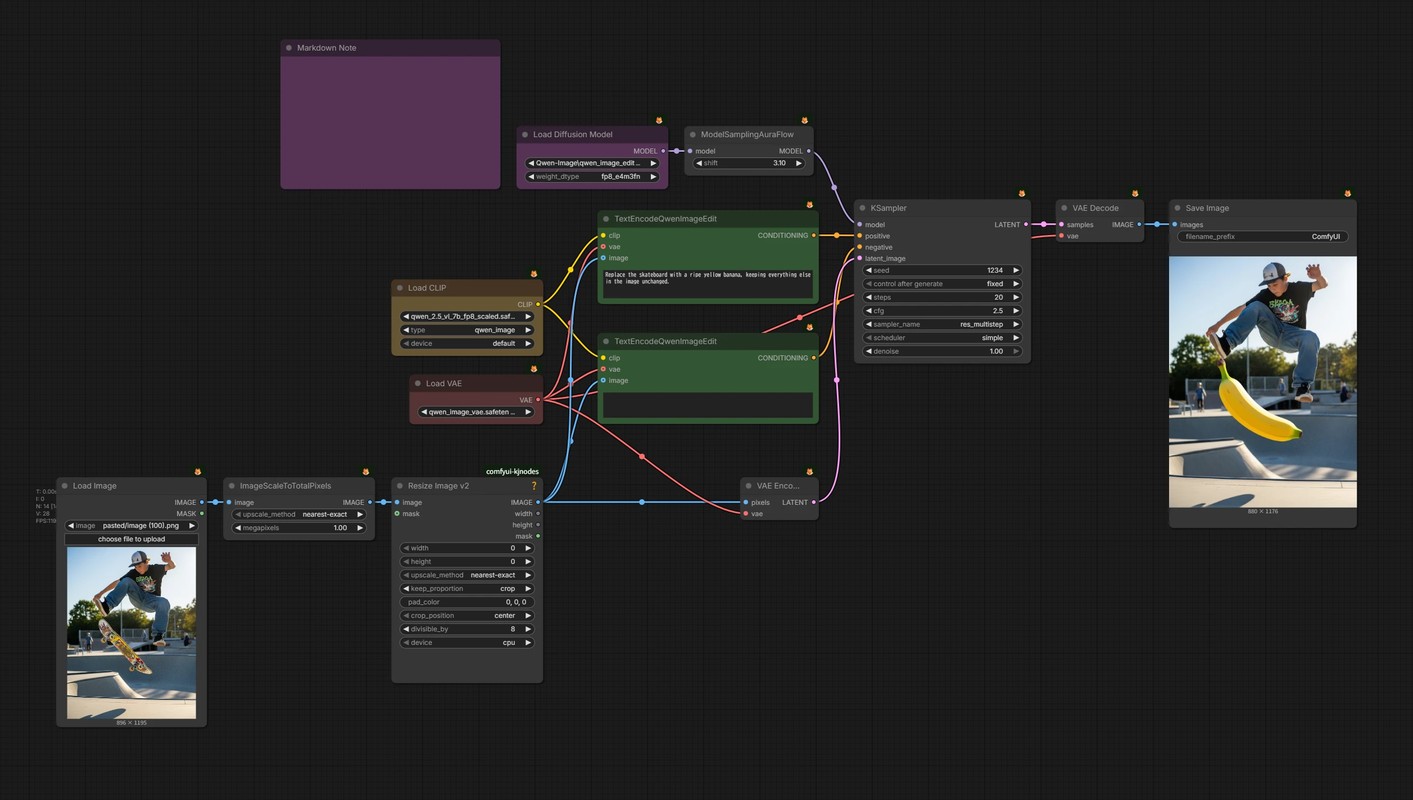
🟩 TextEncodeQwenImageEdit ノードの挙動について、少しだけ補足しておきます。
内部では、ざっくり次のような処理をしています。
- 1. 入力画像を 1M ピクセル程度になるようにリサイズ
- 2. その画像から latent を生成
- 3. テキスト+画像をまとめて Qwen2.5-VL に渡す
画像のリサイズ処理が自動で入るため、生成する画像サイズ を 1M ピクセルから大きく外すと、意図しない結果になる可能性があります。
そのため、この workflow ではあらかじめ画像サイズの下処理をしています。
ImageScaleToTotalPixelsノードで 1M ピクセルにリサイズResize Image v2ノードで、解像度が 8 の倍数になるようにクロップ
Qwen-Image-Edit は、どう工夫しても「入力画像と編集後画像をピクセルパーフェクトに一致させる」ことはできません。
いくつか回避策は提案されていますが、そもそもモデルの設計がそういう用途向きではない、という前提は押さえておいたほうがよいです。
Qwen-Image-Edit-2509
Qwen-Image-Edit-2509 は、無印版を拡張したバージョンです。 最大の違いは、参照画像を複数枚入力できる ことです。
モデルのダウンロード
-
diffusion_models
-
gguf(任意)
📂ComfyUI/
└── 📂models/
    ├── 📂diffusion_models/
    │   └── qwen_image_edit_2509_fp8_e4m3fn.safetensors
    └── 📂unet/
        └── qwen-image-edit-2509.gguf      ← gguf を使う場合のみ
workflow(1枚)
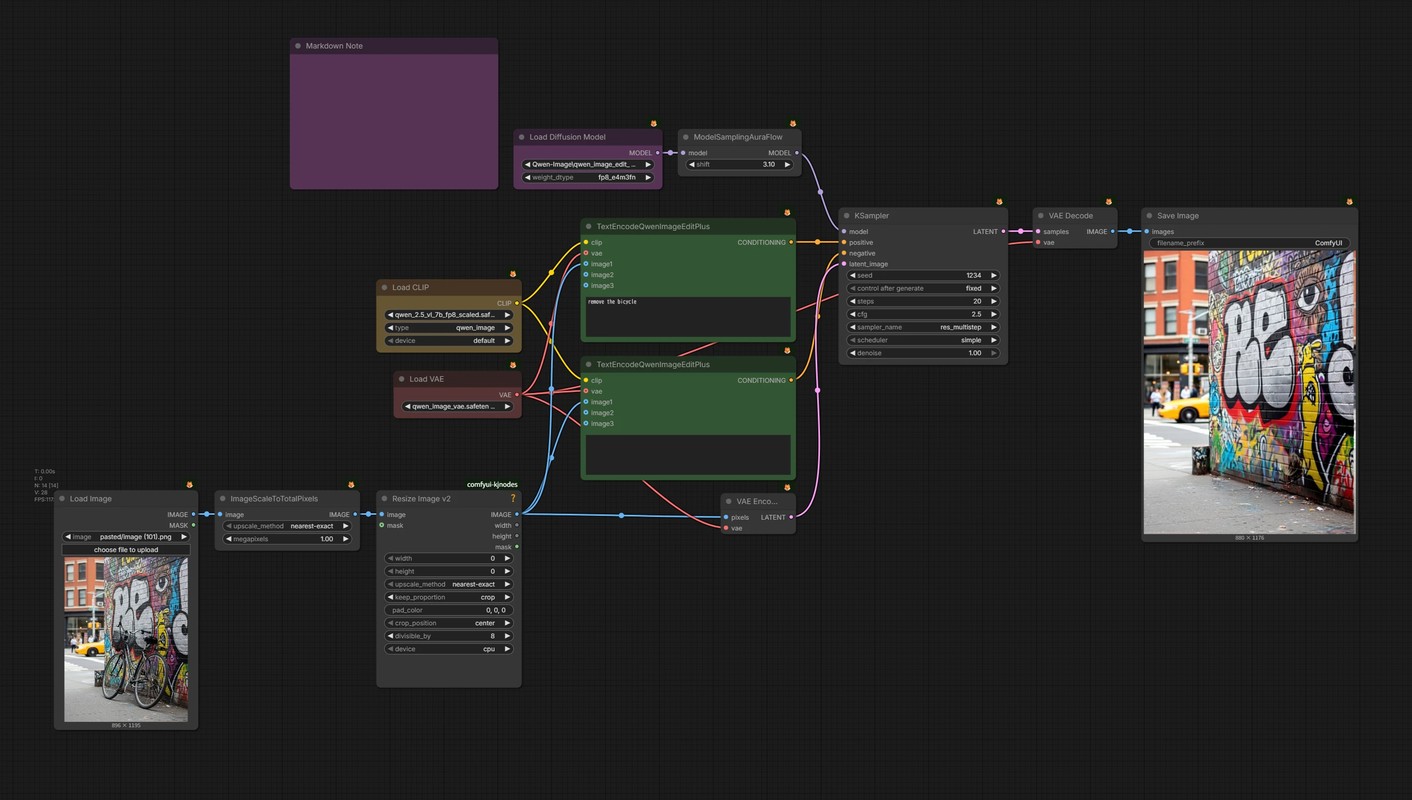
- 基本的な流れは無印版と同じですが、
TextEncodeQwenImageEditノード をTextEncodeQwenImageEditPlusノードに置き換えます。
workflow(複数枚)
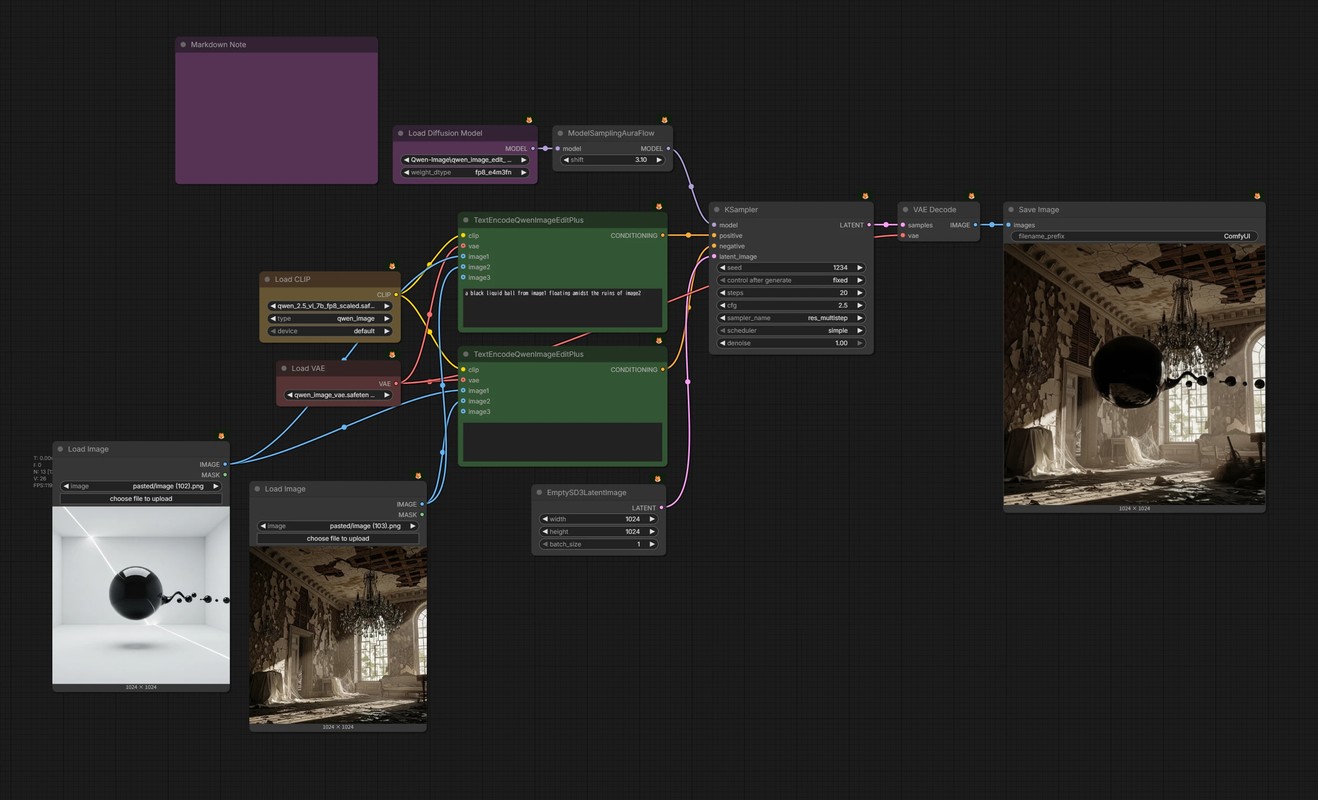
- 🟩 画像をきちんと見ているので、ある程度アバウトな指示でも動きますが、「image1 の〇〇」「image2 の〇〇」のように、どの画像かを明示的に指定することもできます。
これまでは、入力画像と編集後画像をなるべく同じサイズに仕上げたかったため、先にリサイズ処理を行い、それを latent_image に入力していました。
一方で「参照画像をヒントに新しい画像を生成したいだけ」のケースでは、text2image のように EmptySD3LatentImage ノードを使っても問題ありません。
Qwen-Image-Edit-2511
Qwen-Image-Edit-2511 は、2509を改良した新モデルです。
無印から2509のときほど大幅な変化はないですが、キャラクターの一貫性が向上したり、Relighting LoRAなど人気のあるLoRAモデルが統合されたりと着実な改良がされています。
モデルのダウンロード
-
diffusion_models
-
gguf(任意)
📂ComfyUI/
└── 📂models/
    ├── 📂diffusion_models/
    │   └── qwen_image_edit_2511_fp8mixed.safetensors
    └── 📂unet/
        └── qwen-image-edit-2511-XXXX.gguf      ← gguf を使う場合のみ
workflow
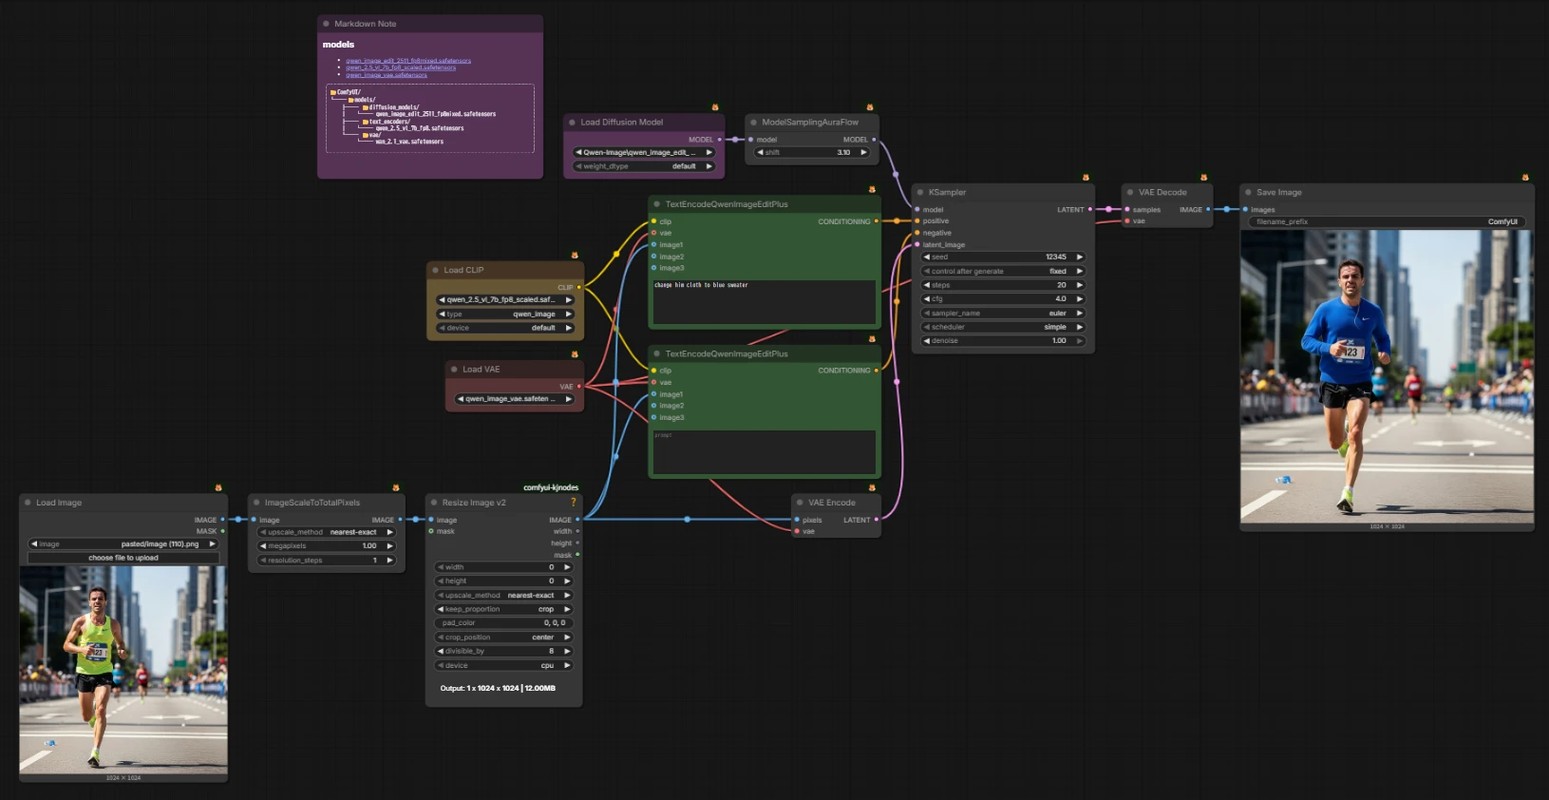
2509とまったく同じworkflowで動きます。
Lightning
Qwen-Image-Edit-Lightning は、Qwen-Image-Edit を 4 / 8 steps で回せるように蒸留した LoRA セットです。
ほとんど劣化なしでステップ数を大幅に減らせるため、多くの workflow で採用されています。
モデルのダウンロード
-
loras
📂ComfyUI/
└── 📂models/
    └── 📂loras/
        ├── Qwen-Image-Edit-2509-Lightning-4steps-V1.0-bf16.safetensors
        ├── Qwen-Image-Edit-2509-Lightning-8steps-V1.0-bf16.safetensors
        └── Qwen-Image-Edit-2511-Lightning-4steps-V1.0-bf16.safetensors
Qwen-Image-Edit-2509
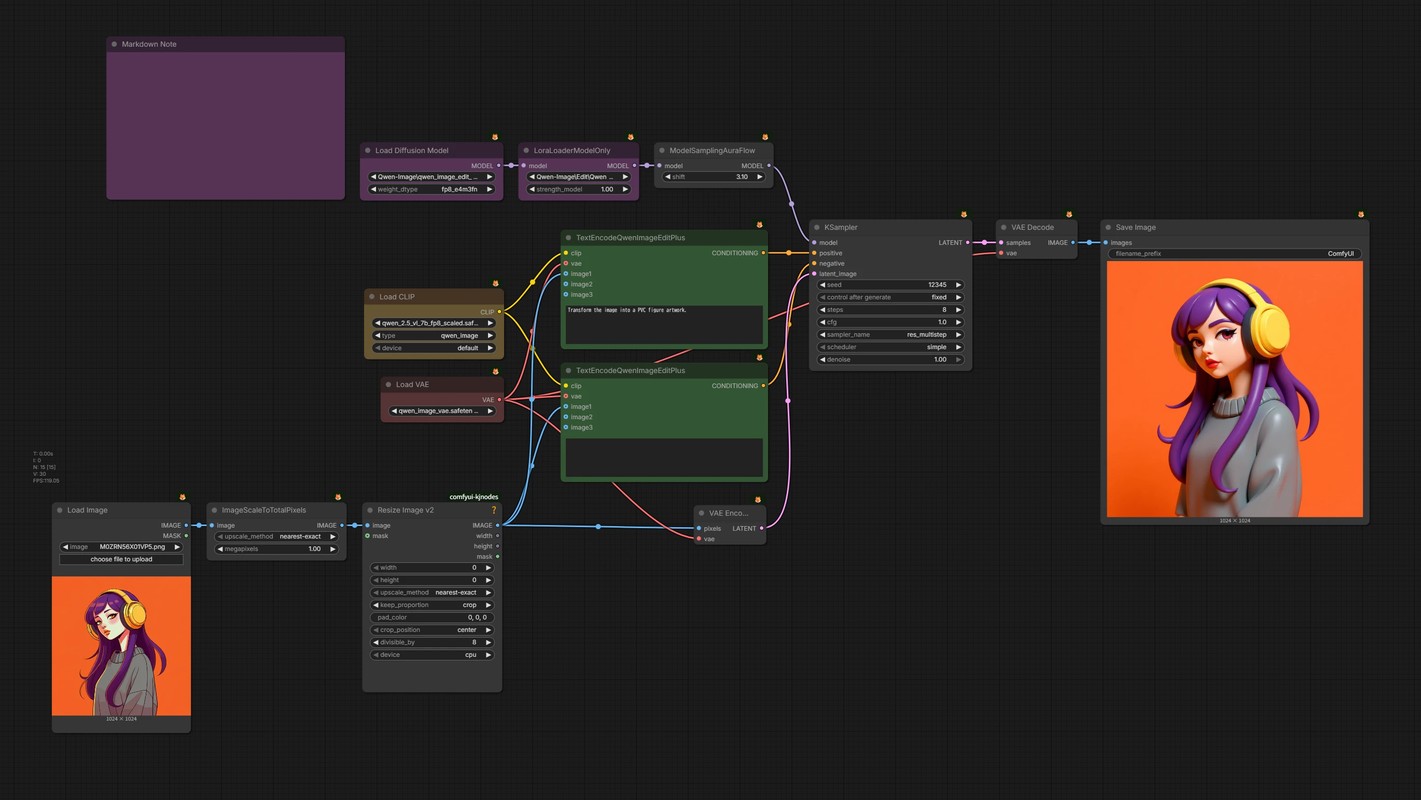
LoraLoaderModelOnlyノードで Lightning LoRA を読み込みます。KSamplerのstepsを 4 または 8、CFGを 1.0 に設定します。
Qwen-Image-Edit-2511
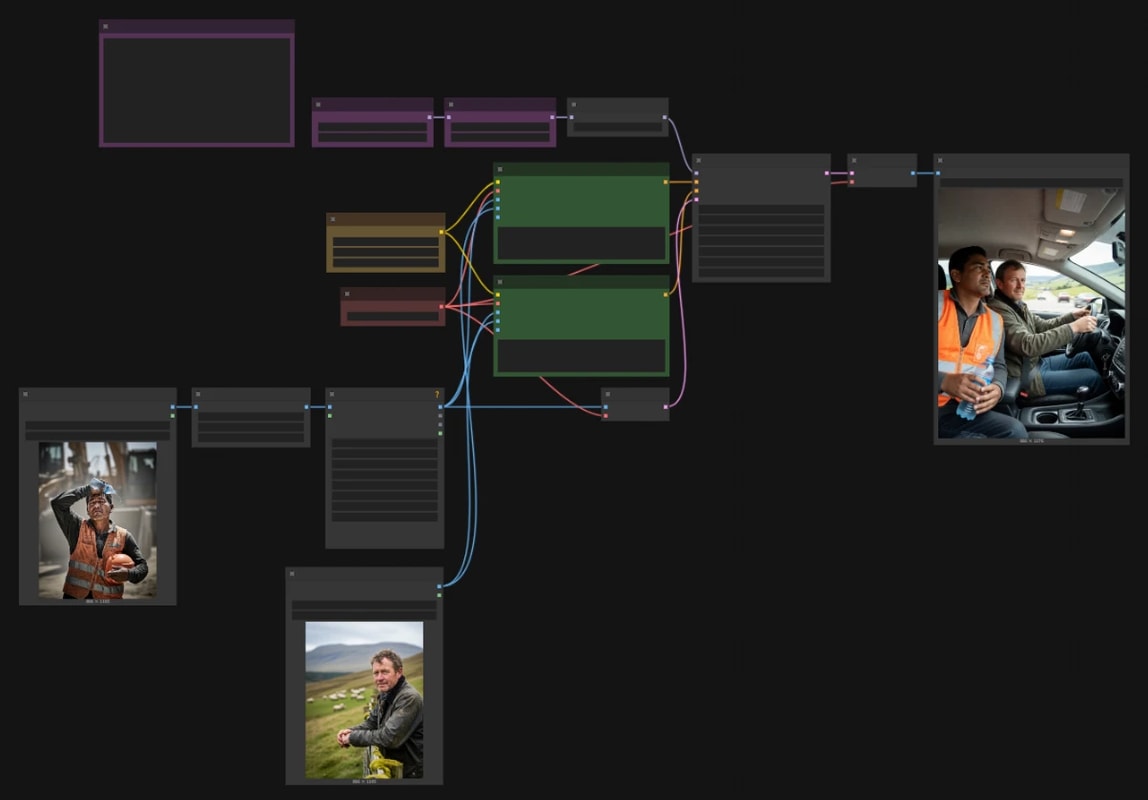
LoraLoaderModelOnlyノードで Lightning LoRA を読み込みます。