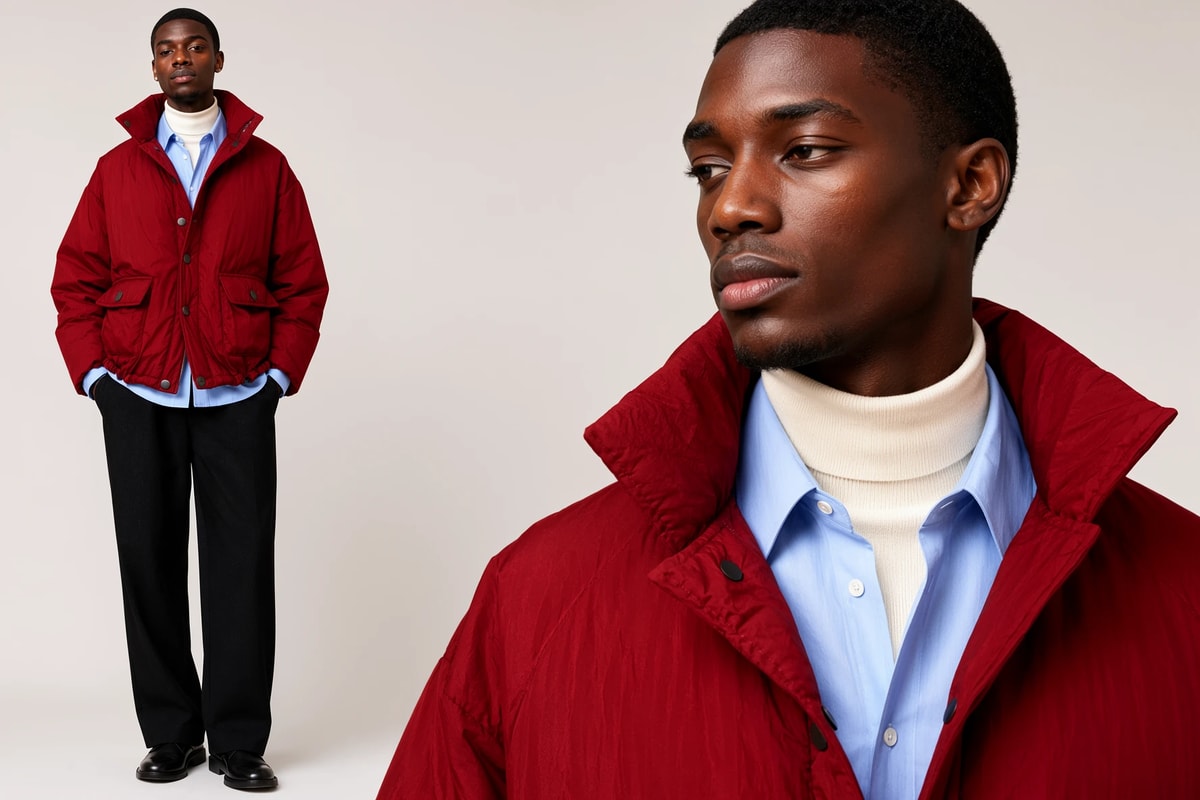
Pika H3 Flexとは?
Pika H3 Flex は、Pika が MiniMax H3 を追加学習したモデルです。
Pika は自社でも動画生成モデルを作っている会社で、学習にはそのデータセットが使われています。
品質が上がっているのに加え、ステップ蒸留で 6 ステップになっており、非常に快適に生成できます。
基本的な使い方は MiniMax H3 と同じです。プロンプトの書き方や使用するノードは、そちらを見てください。
推奨設定値
- 解像度
- 768p、約 1MP
- 幅と高さは 32 の倍数にします
- FPS
- 24 FPS
- フレーム数
17n + 5
- 動画の長さ
- 5〜15 秒
モデルのダウンロード
LoRA
- loras
- pika_h3_flex_fl2va_v1_bf16.safetensors (1.96 GB)
- pika_h3_flex_ref2va_v1_bf16.safetensors (1.96 GB)
📂ComfyUI/
└── 📂models/
    └── 📂loras/
        ├── pika_h3_flex_fl2va_v1_bf16.safetensors
        └── pika_h3_flex_ref2va_v1_bf16.safetensors
ベースモデル
- checkpoints
- sam3.1_multiplex_fp16.safetensors (1.75 GB)
- diffusion_models
- text_encoders
- vae
📂ComfyUI/
└── 📂models/
    ├── 📂checkpoints/
    │   └── sam3.1_multiplex_fp16.safetensors
    ├── 📂diffusion_models/
    │   ├── minimax_h3_fl2va_pruned_int8_convrot.safetensors
    │   └── minimax_h3_ref2va_pruned_int8_convrot.safetensors
    ├── 📂text_encoders/
    │   └── qwen3vl_32b_minimax_h3_nvfp4_awq.safetensors
    └── 📂vae/
        ├── minimax_h3_audio_vae_fp32.safetensors
        └── minimax_h3_video_vae_int8_convrot.safetensors
text2video / T2VA
使用モデル:fl2va
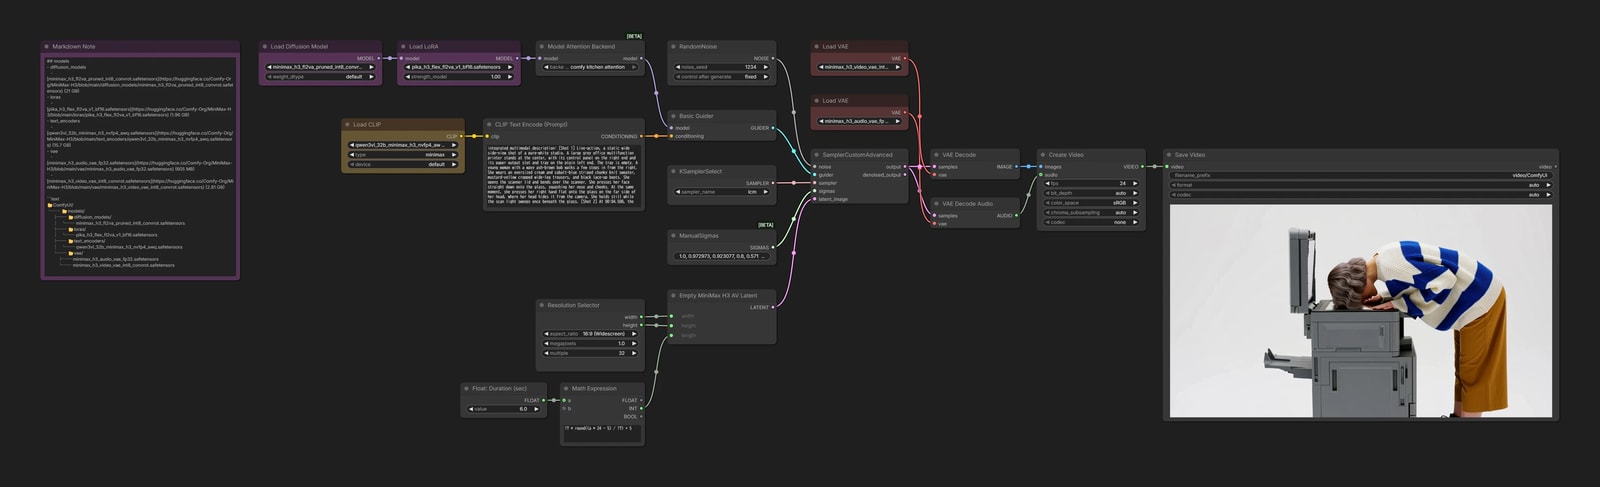
Load LoRApika_h3_flex_fl2va_v1_bf16.safetensorsを strength1.0で適用します
SamplerCustomAdvanced+ManualSigmas- Pika が指定している 6 ステップの sigma を使います
1.0, 0.972973, 0.923077, 0.8, 0.571429, 0.333333, 0.0- sampler は
lcmです
Outputs
image2video / I2VA
使用モデル:fl2va
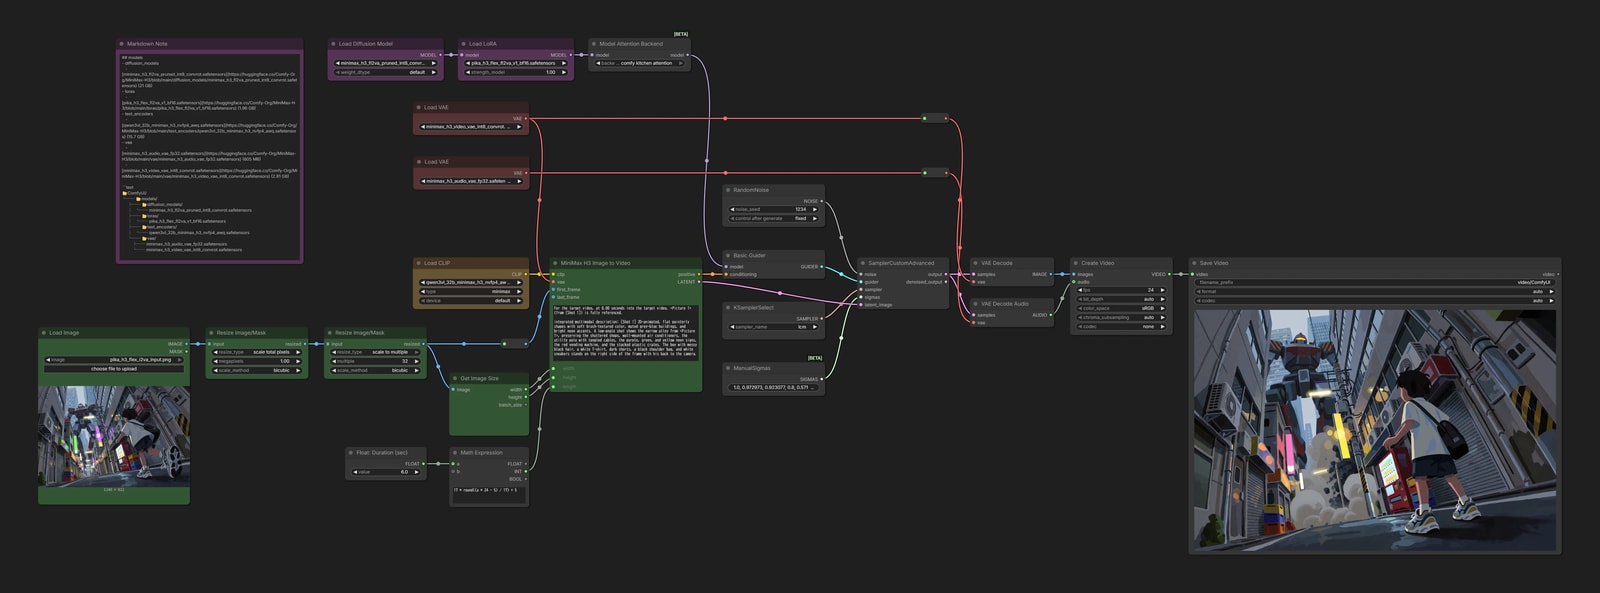
Outputs
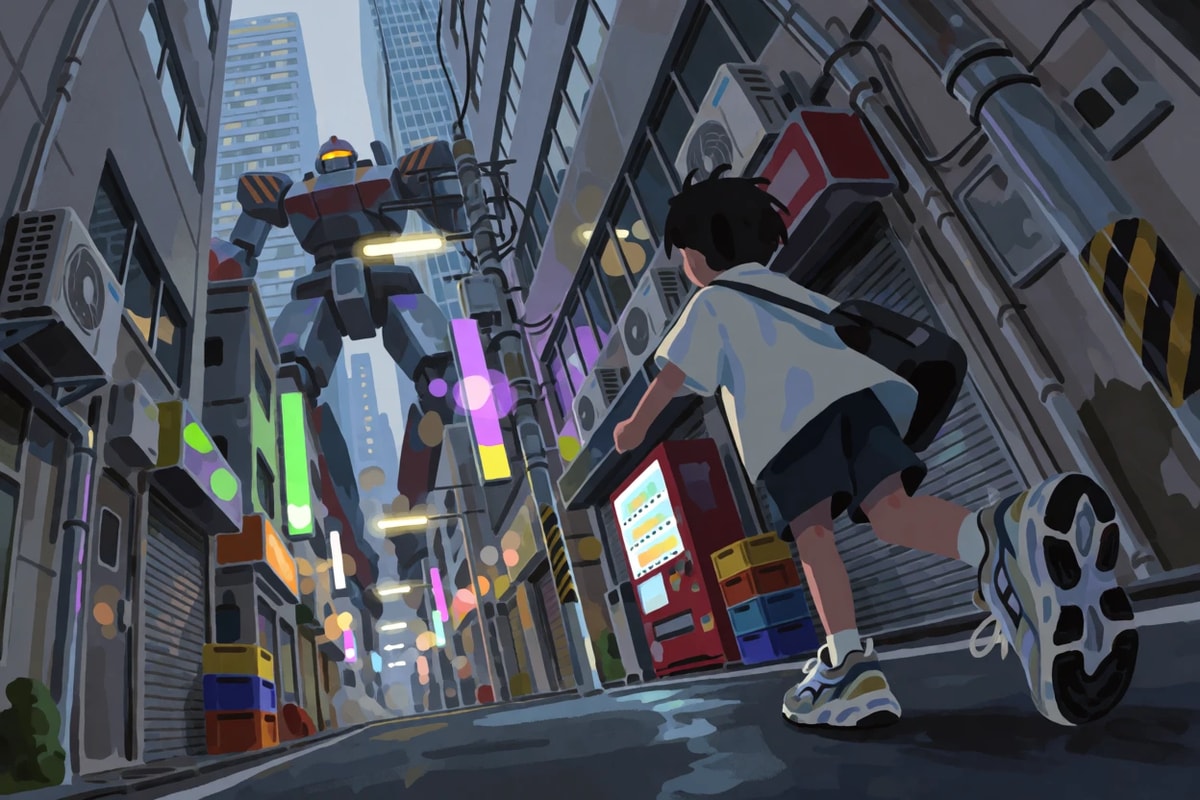
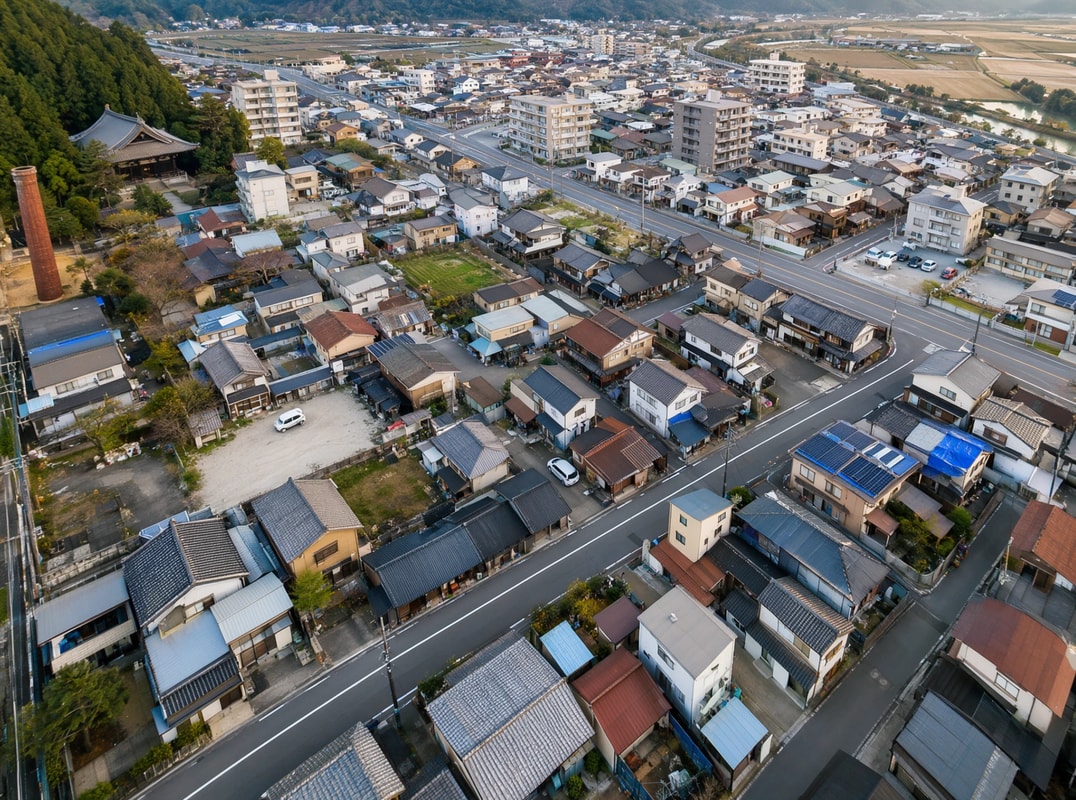
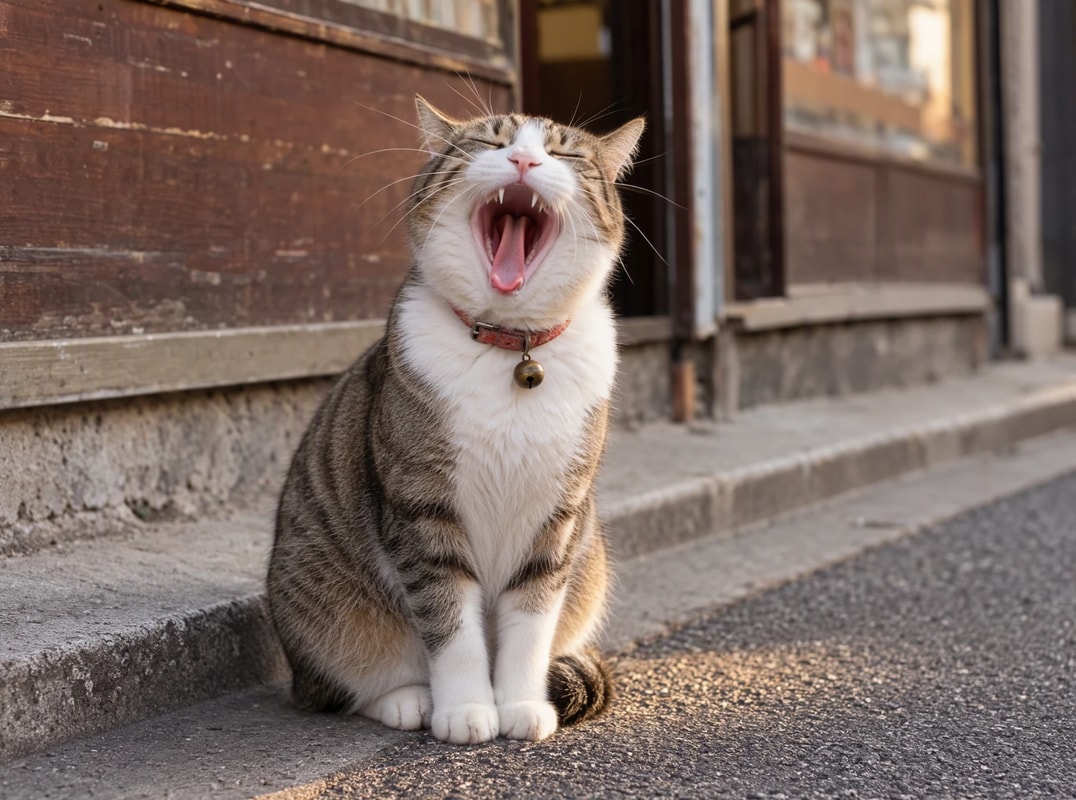
First / Last Frame to Video
使用モデル:fl2va
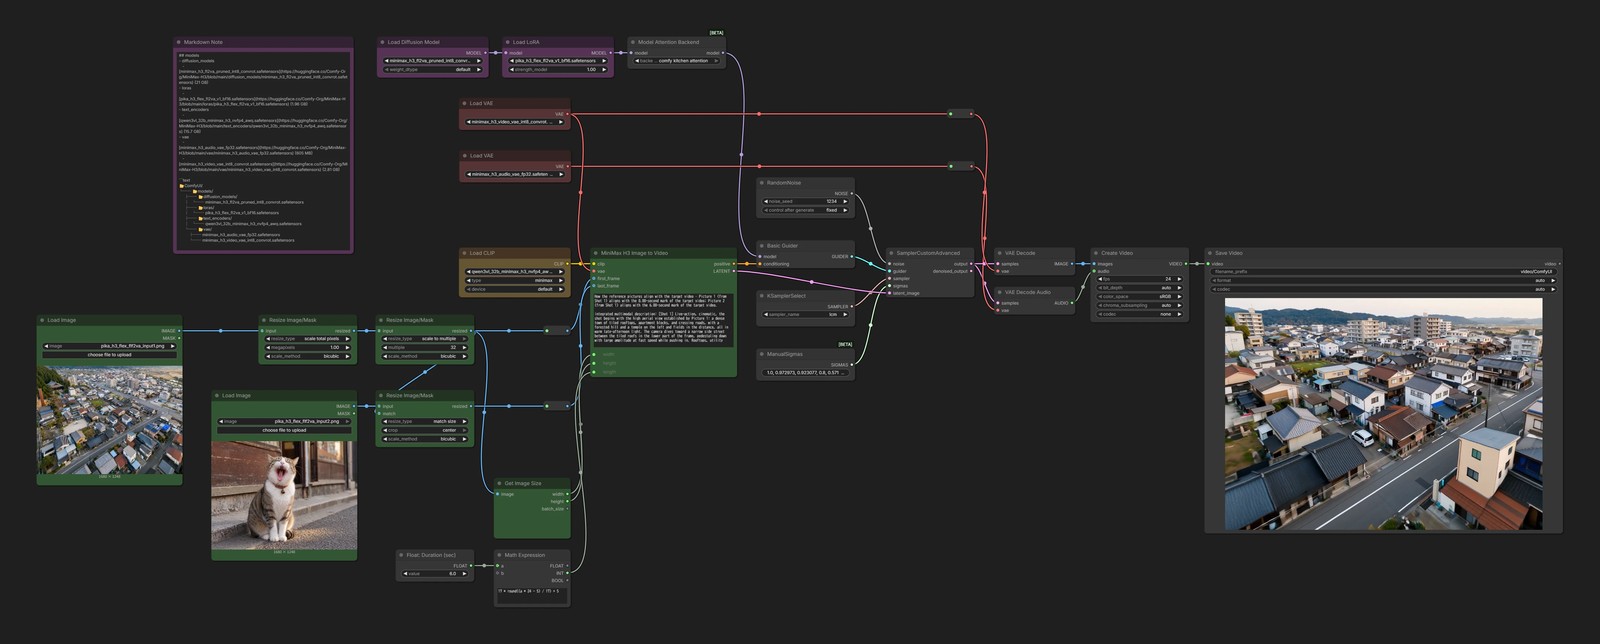
Outputs
Reference Generation
使用モデル:ref2va
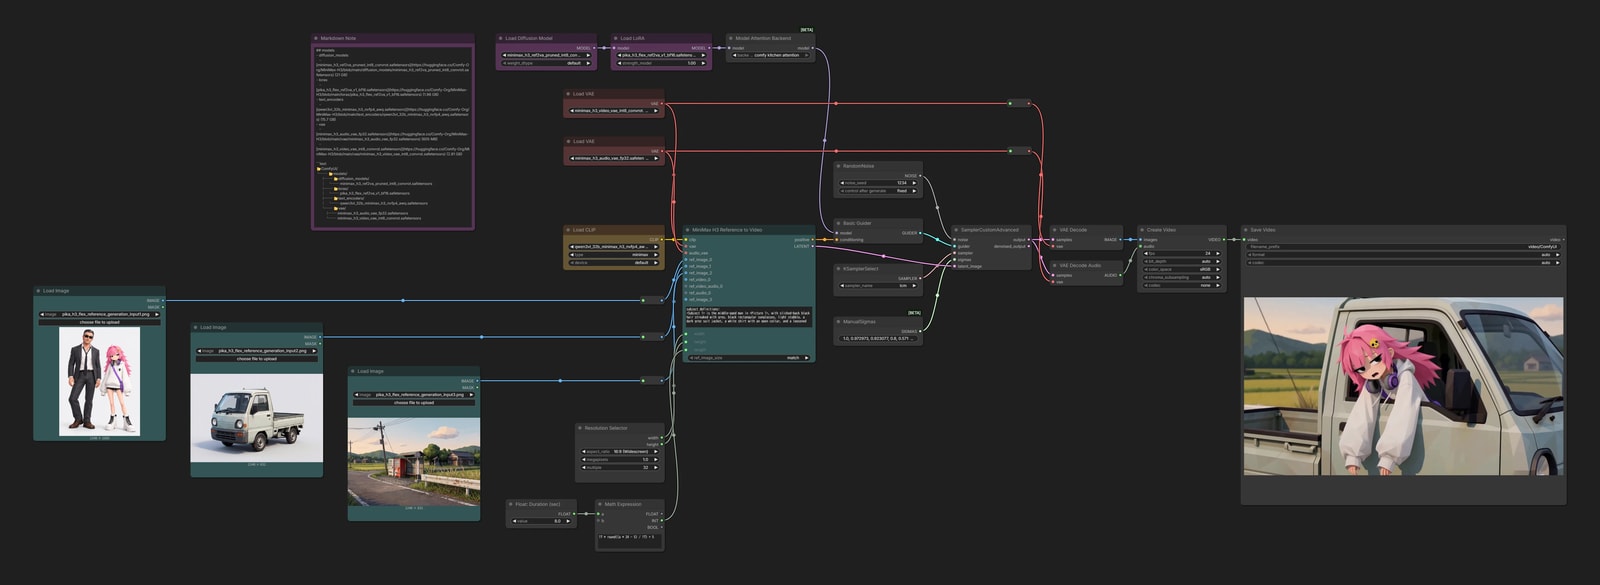
Load LoRApika_h3_flex_ref2va_v1_bf16.safetensorsを strength1.0で適用します
Outputs
Video Editing
使用モデル:ref2va
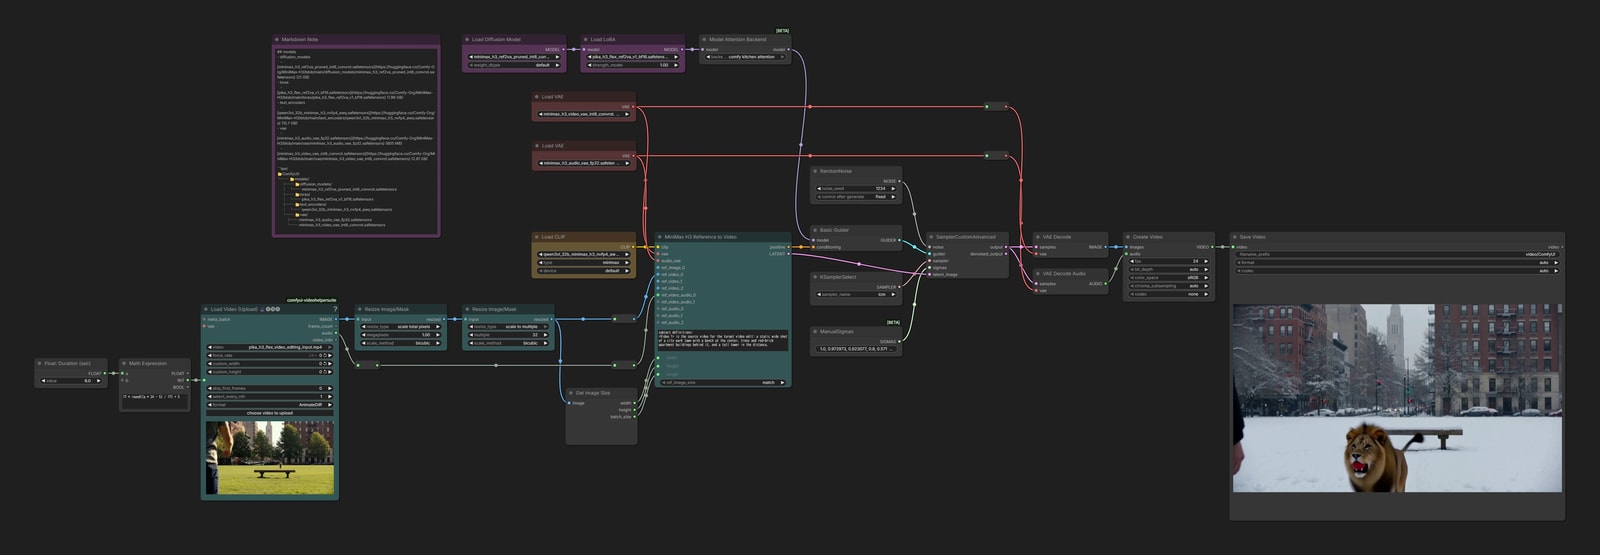
Outputs
空間 Inpainting
使用モデル:ref2va
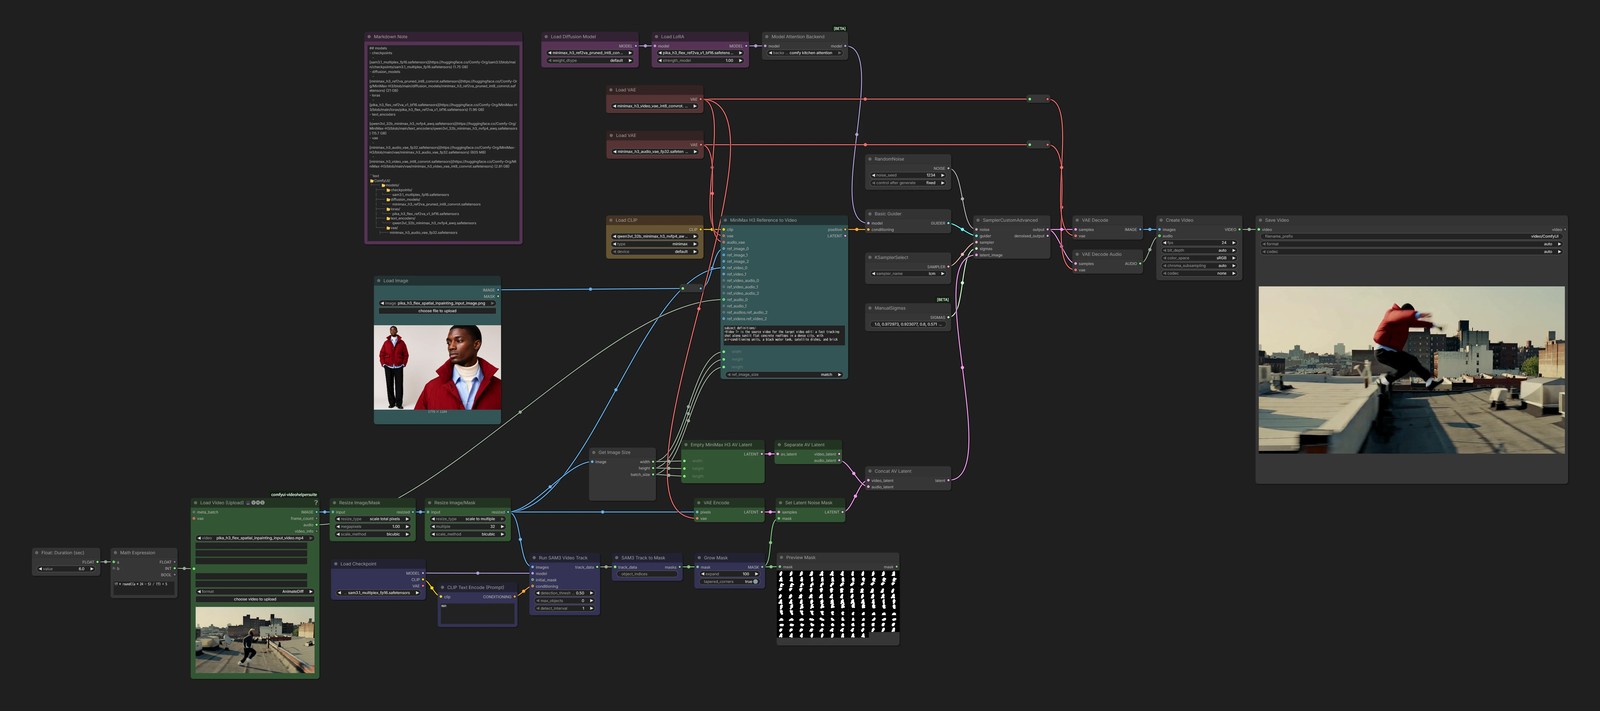
Outputs