MOSS-Imageとは?
MOSS-Image は、約32億枚の画像でゼロから事前学習された 5B の画像生成モデルです。
面白いのは、学習データにほとんど品質フィルタをかけていないことで、透かしやボケのある画像も捨てずにキャプションをつけて学ばせています。
そのおかげか、表現の自由度が非常に高いです。とくにアニメ系の絵がここまでまとまっているモデルは、最先端のモデルを見渡してもなかなか見当たりません。
商用も可能な寛容なライセンスを持っているため、これからコミュニティでどう育っていくのか楽しみなモデルです。
推奨設定値
- 解像度
- 1MP 〜 2MP(最大 4MP)
- 縦横ともに 16 の倍数
モデルのダウンロード
- diffusion_models
- moss_image_sft_int8_convrot.safetensors (5.41 GB)
- text_encoders
- qwen3.5_9b_int8_convrot.safetensors (9.75 GB)
- vae
- flux2-vae.safetensors (336 MB)
📂ComfyUI/
└── 📂models/
    ├── 📂diffusion_models/
    │   └── moss_image_sft_int8_convrot.safetensors
    ├── 📂text_encoders/
    │   └── qwen3.5_9b_int8_convrot.safetensors
    └── 📂vae/
        └── flux2-vae.safetensors
プロンプト
自然文だけでなく、タグ形式にも対応しています。タグを使う場合、Anima に似ていますが、以下の順で書いてください。
Quality -> Score -> Meta -> Year -> Character -> Series -> Artist -> General
text2image
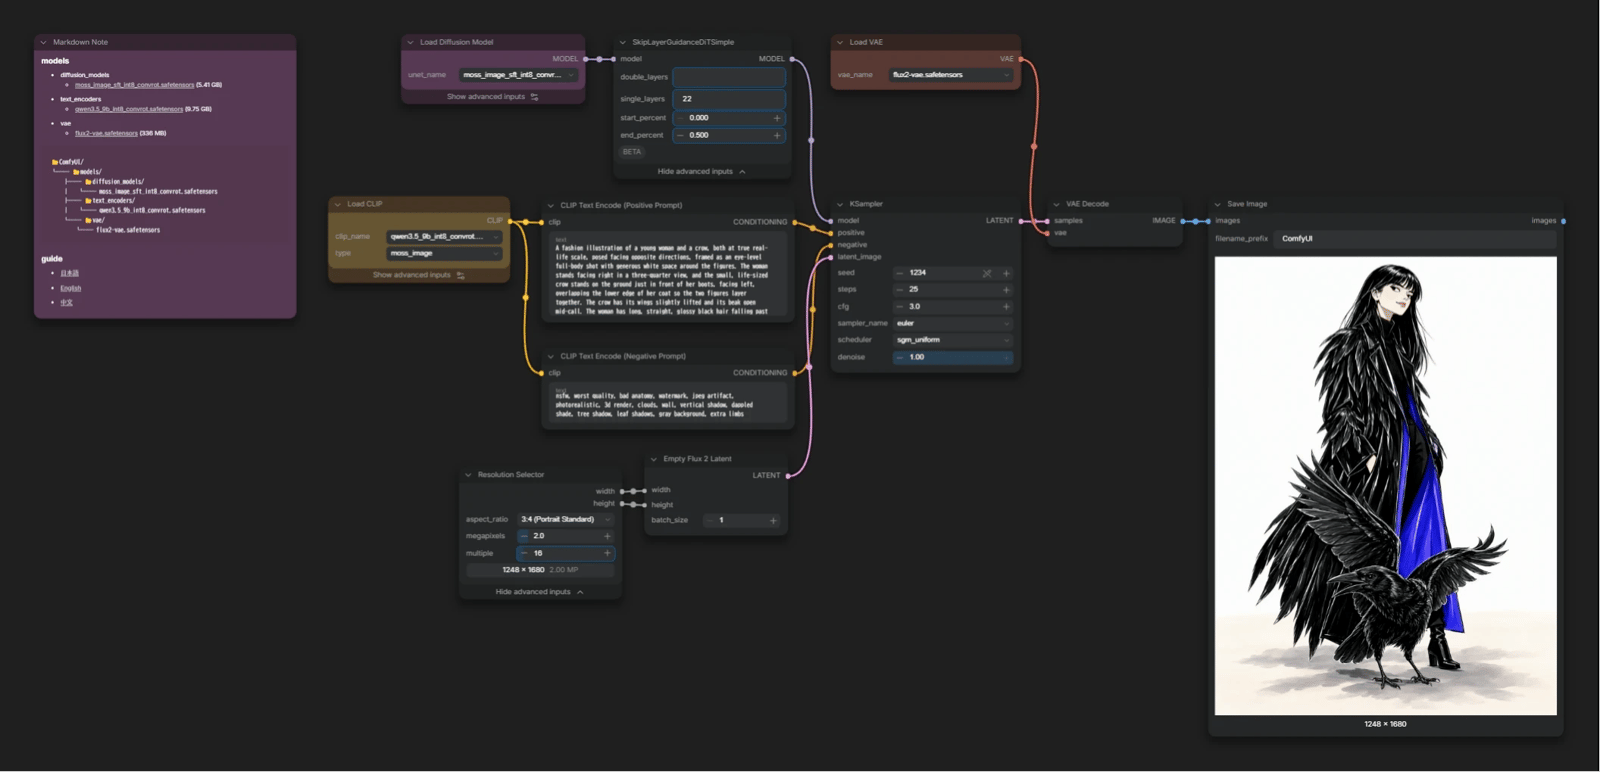
steps: 25cfg: 3.0SkipLayerGuidanceDiTSimplesingle_layers: 22end_percent: 0.5- これをオフにすると、崩れやすくなる代わりに非常にリアルになる…らしいです。オフは確かによく崩れるので、ここでは間をとって 0.5 にしています。
Outputs
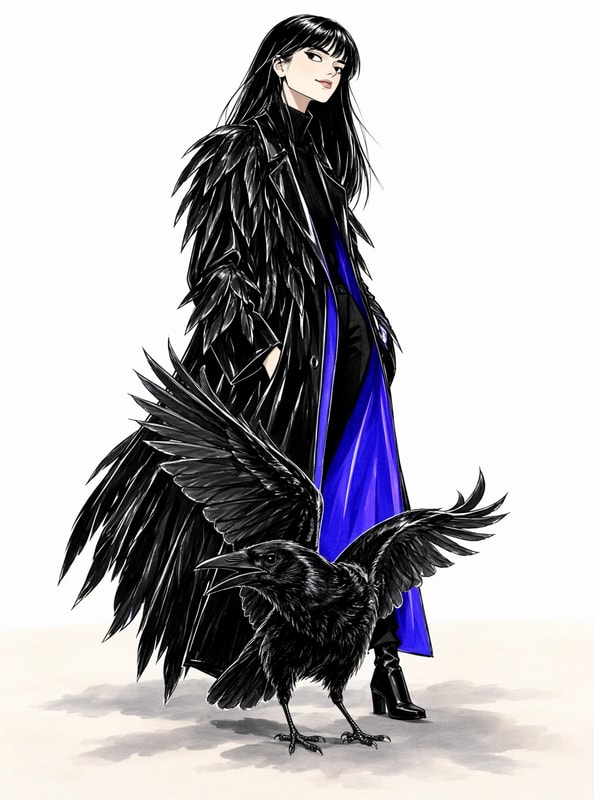
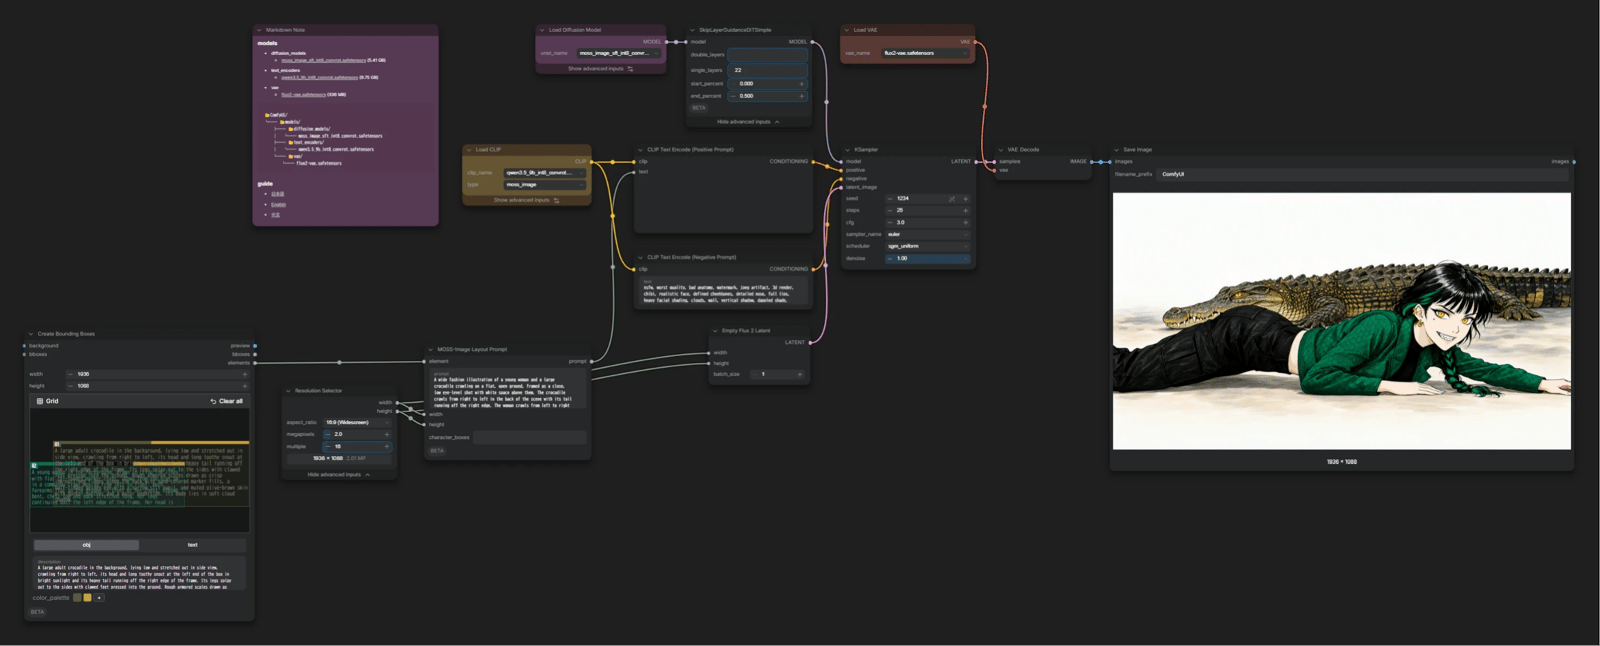
text2image with BBOX
BBOX で、どこに何を置くかを指定できます。
-
Create Bounding Boxes- BBOX を描くためのコアノードです。ドラッグでボックスを追加して、そこに置きたいものを書いていきます。
width/heightは、出力サイズ(Resolution Selectorの値)に合わせます。
width/heightにはResolution Selectorの値をつなぎたくなりますが、今はバグがあり、外部入力で解像度を入力すると BBOX の座標がずれてしまいます。
同じ値を手で入力してください。 -
MOSS-Image Layout Prompt- 画像全体についてのプロンプトを書きます。
- ボックスの情報とプロンプトを、MOSS-Image が学習している JSON の形にまとめて出してくれます。
Outputs