WeVisOne-VLとは?
WeVisOne-VL は、Tencent が公開した、Qwen3-VL を知覚タスク専用にファインチューンしたモデルです。
物体検出・セグメンテーション・カウント・OCR を、1つのモデルでこなします。
近いものに Florence-2 がありますが、ベースとなるモデルが圧倒的に進化しており、複雑なプロンプトへの対応力は順当に上がっています。
モデルのダウンロード
- text_encoders
- wevisone_vl_4b_int8_convrot.safetensors (5.29 GB)
- wevisone_vl_2b_int8_convrot.safetensors (2.89 GB)
📂ComfyUI/
└── 📂models/
    └── 📂text_encoders/
        ├── wevisone_vl_2b_int8_convrot.safetensors
        └── wevisone_vl_4b_int8_convrot.safetensors
WeVisOne-VL Detect
task を切り替えて使い分けます。
segmentation
対象を文章で指定すると、マスクと BBOX が出力されます。
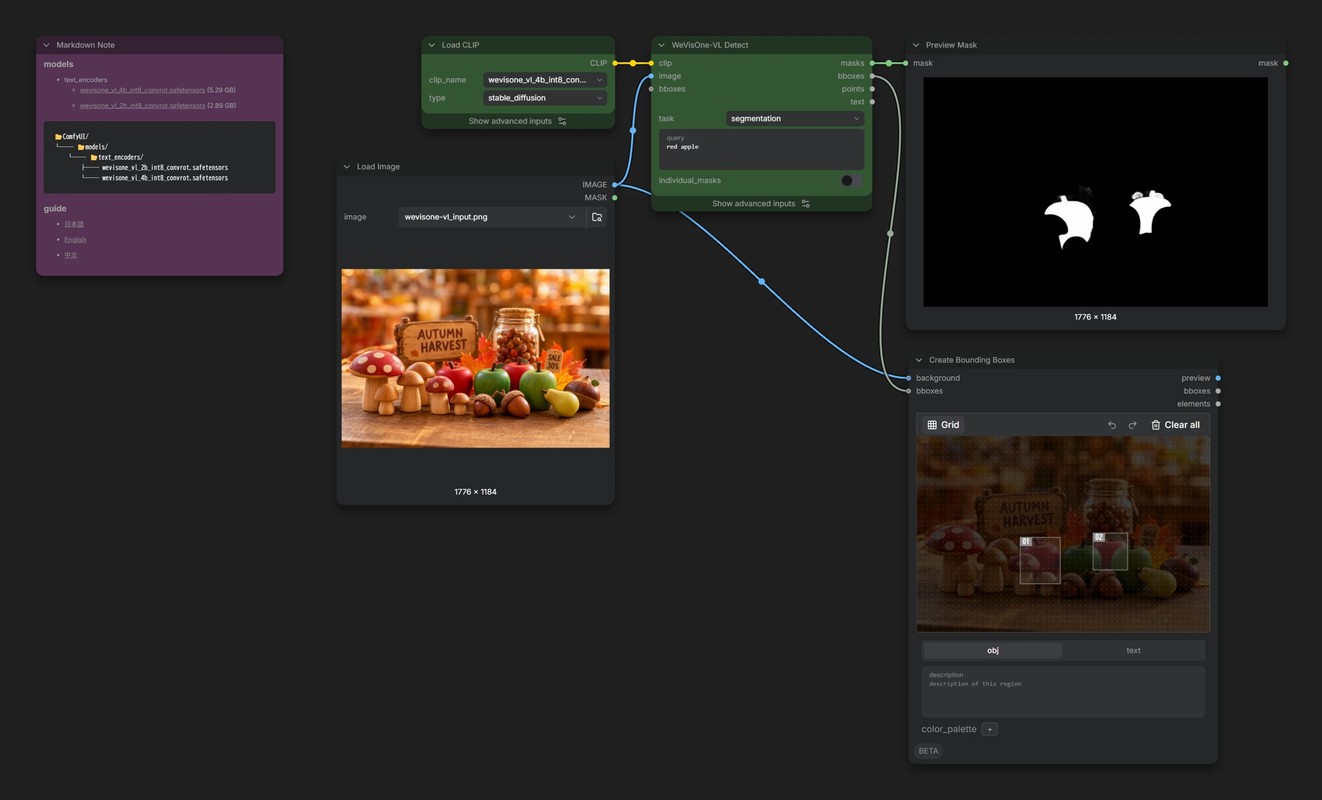
individual_masksをオンにすると、対象が複数あった場合、それぞれが別々のマスクとして出力されます。
detection / referring
基本的には、segmentation からマスクの出力がなくなっただけです。
detection と referring は、正確には内部で別のプロンプトが使われていますが、試した限りほとんど同じ結果になります。そもそも segmentation でも BBOX が出力されるので、それほど使う場面はないかなと思います。
point
BBOX の代わりに、オブジェクトの位置を座標で出します。
count_box / count_point
対象のオブジェクトの数を数えます。
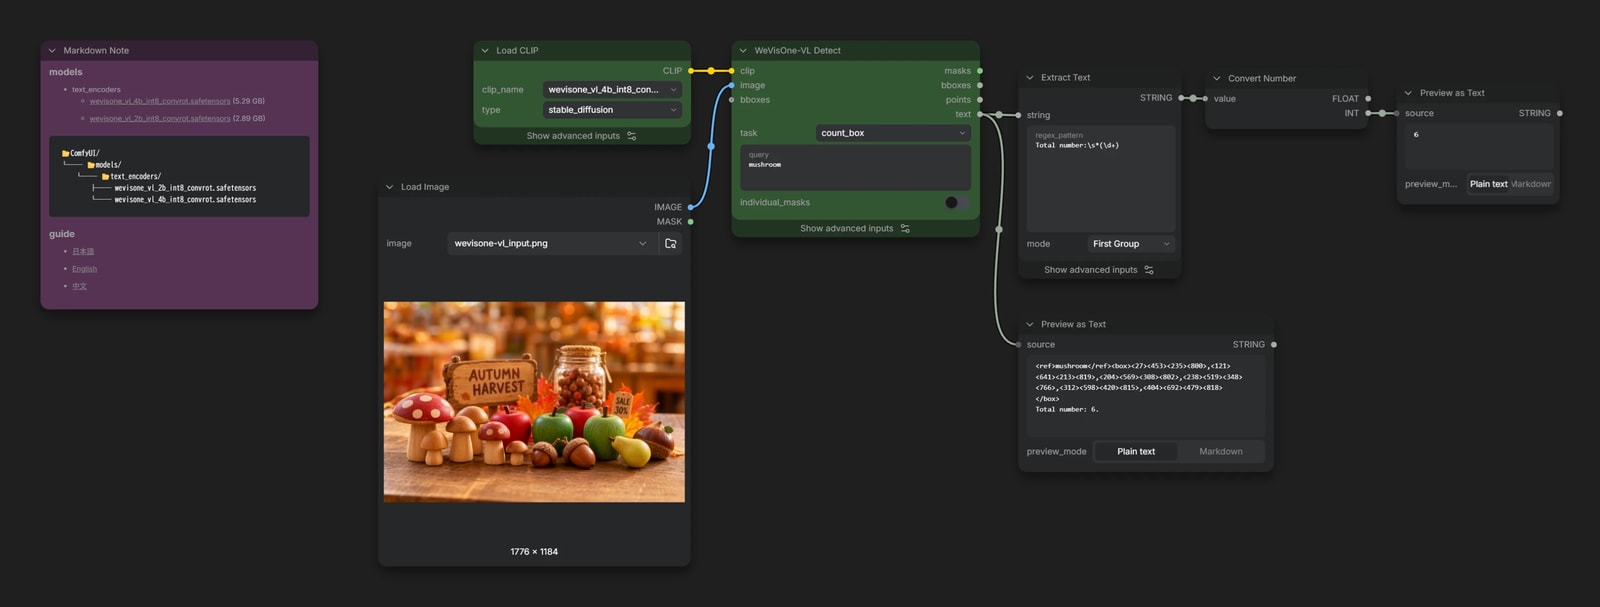
Total number: 6. のような文章で出てくるため、少し使いにくいですね。
この workflow では、Extract Text の正規表現で数だけを取り出し、Convert Number で INT に変換しています。
ocr
画像内のテキストを抽出します。
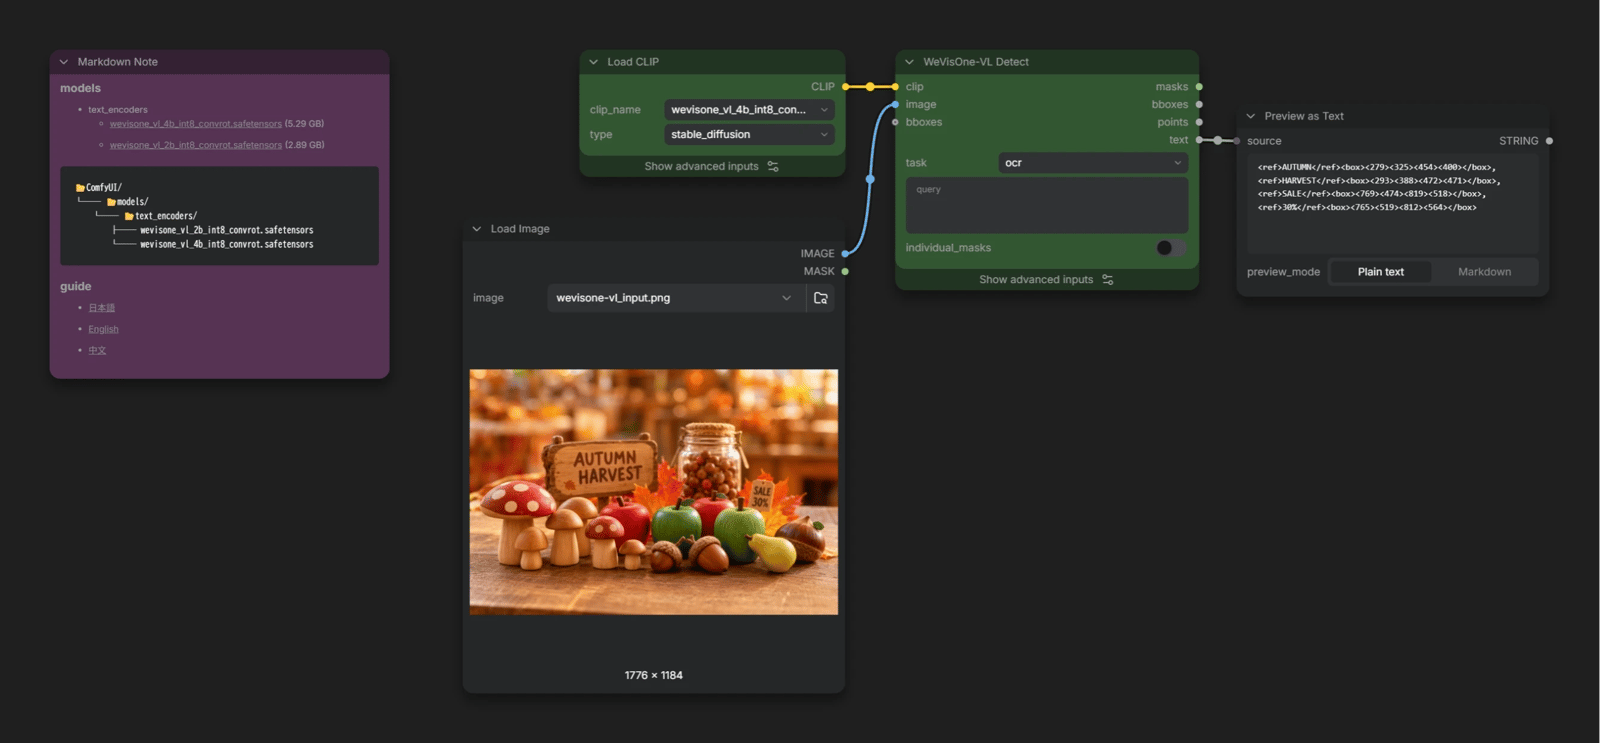
単語ごとに、座標と内容が text として出力されます。
残念ながら日本語は苦手そうです。
ocr_grounding
ocr とは逆で、探したい文字列を書くと、それが画像のどこにあるかを BBOX で出力します。
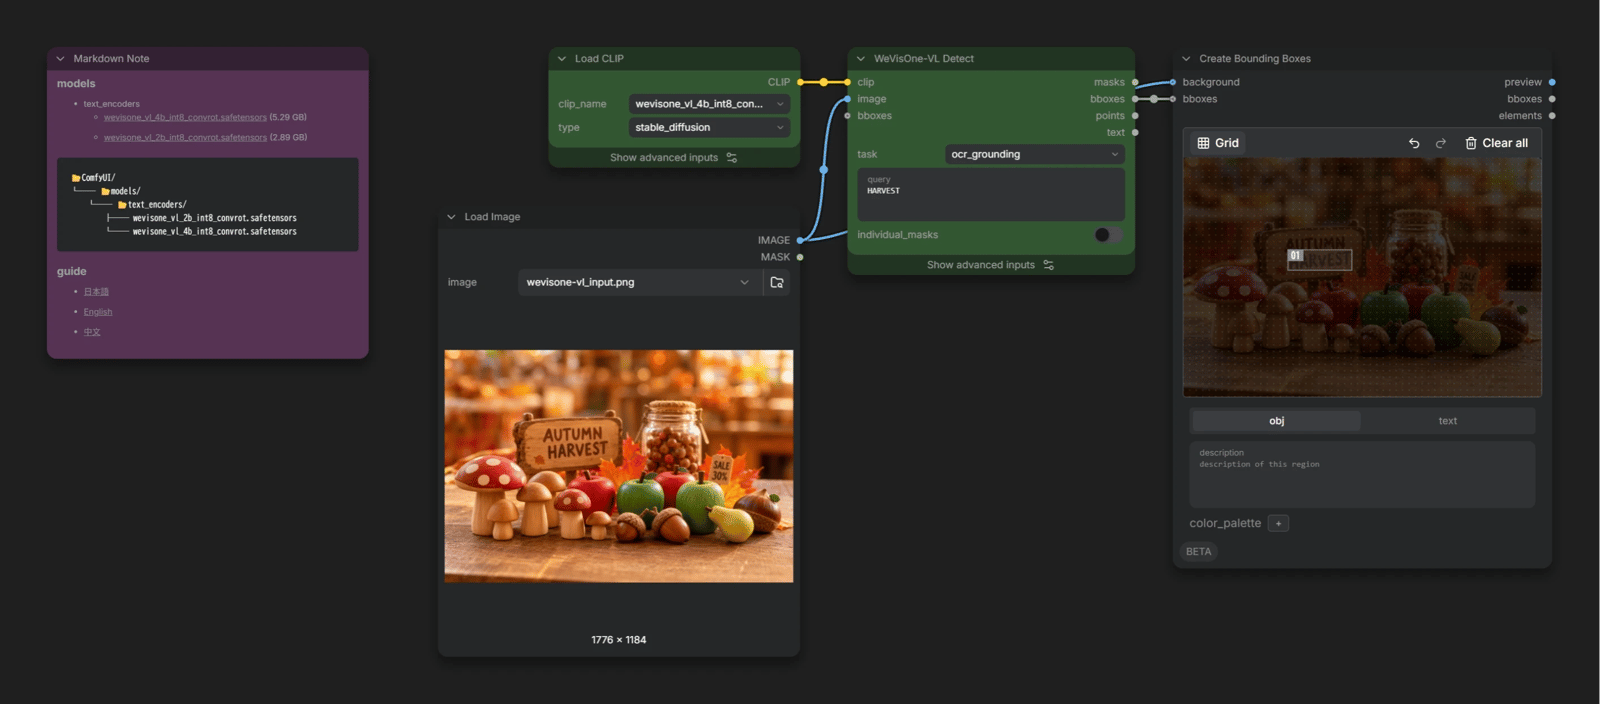
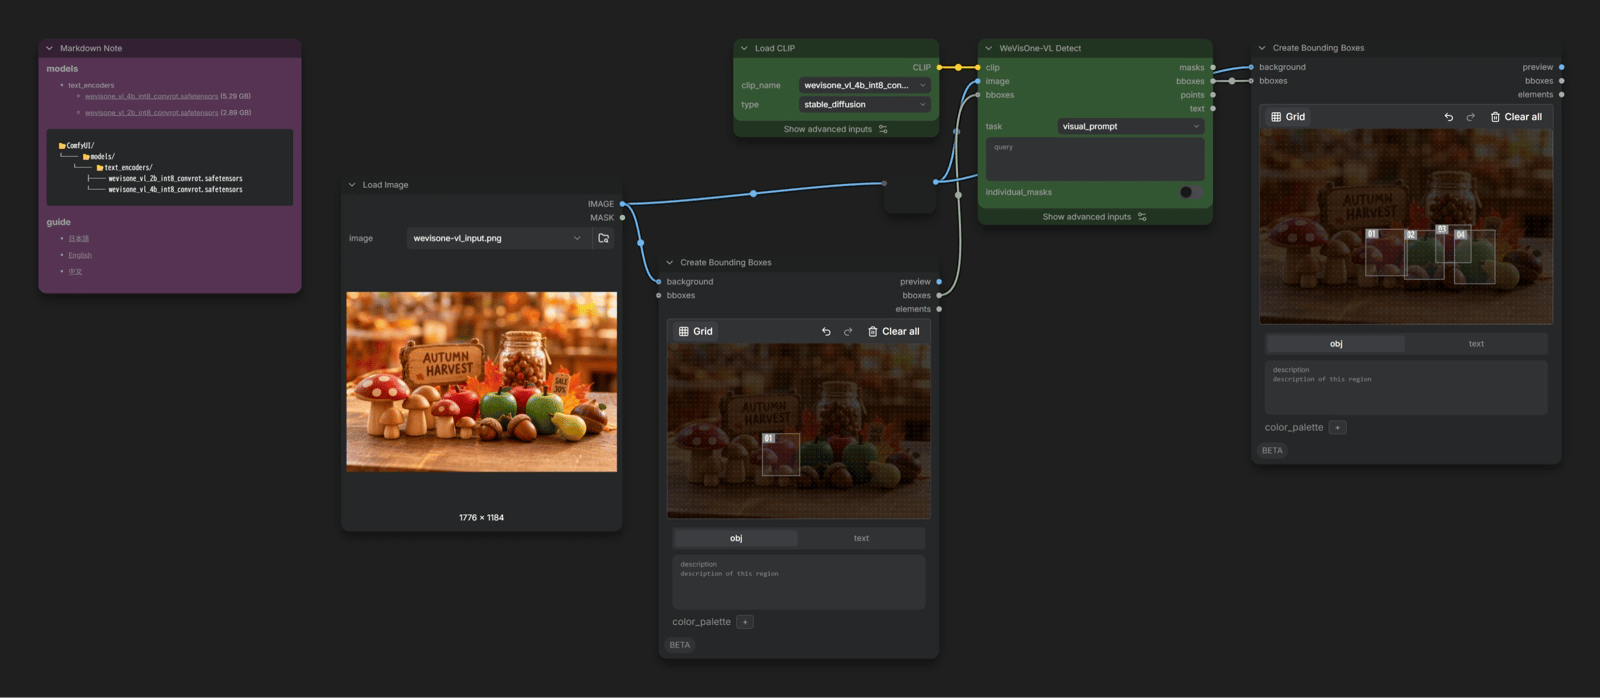
visual_prompt
画像の中の囲った物と同じ物を、同じ画像の中から探します。
参照画像を使う、というようなものではないので、活用するのが難しいかもしれません。
freeform
上はそれぞれのタスクに合わせて入力・出力が整えられていましたが、このモードでは、query に書いた文が、そのままプロンプトとして渡されます。
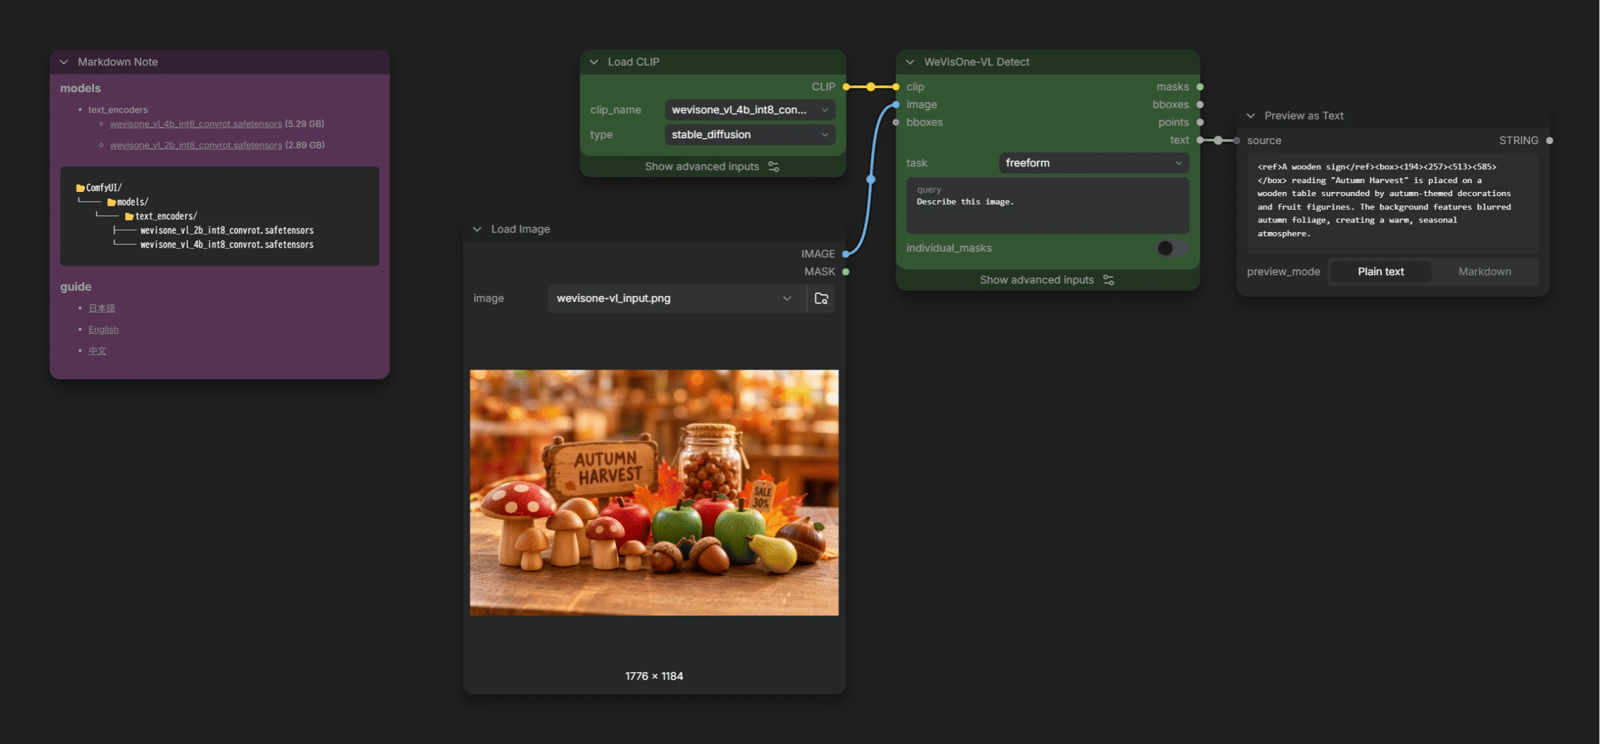
Describe this image. のように書けば、普通の VLM として画像の説明にも使えます。ただ、知覚タスク用に作られたモデルなので、こういった使い方なら、通常の Qwen3-VL のほうがよいでしょう。