使用 AI 生成蒙版
在 inpainting 等场景中,经常需要制作蒙版。但每次都手动绘制,或者提前准备蒙版图像,非常麻烦。最重要的是,这样无法自动化。
但是,单纯说一句“把这部分做成蒙版”,并不一定就能轻松得到干净的蒙版。
需要把几种 AI 技术组合起来考虑。
- 物体检测 - 找出图像中的目标在哪里。
- 分割 - 将目标的形状切出为蒙版。
- 抠图 - 更细致地处理前景和背景之间的边界。
例如,可以先用物体检测找到目标,再把结果传给分割模型,将其转换成蒙版。
下面看看主要有哪些技术。
物体检测 (Detection)

顾名思义,物体检测可以确定图像中特定物体的位置,并输出称为 BBOX 的矩形范围。
YOLO 系
YOLO 是以实时检测物体为目的的超高速检测技术。
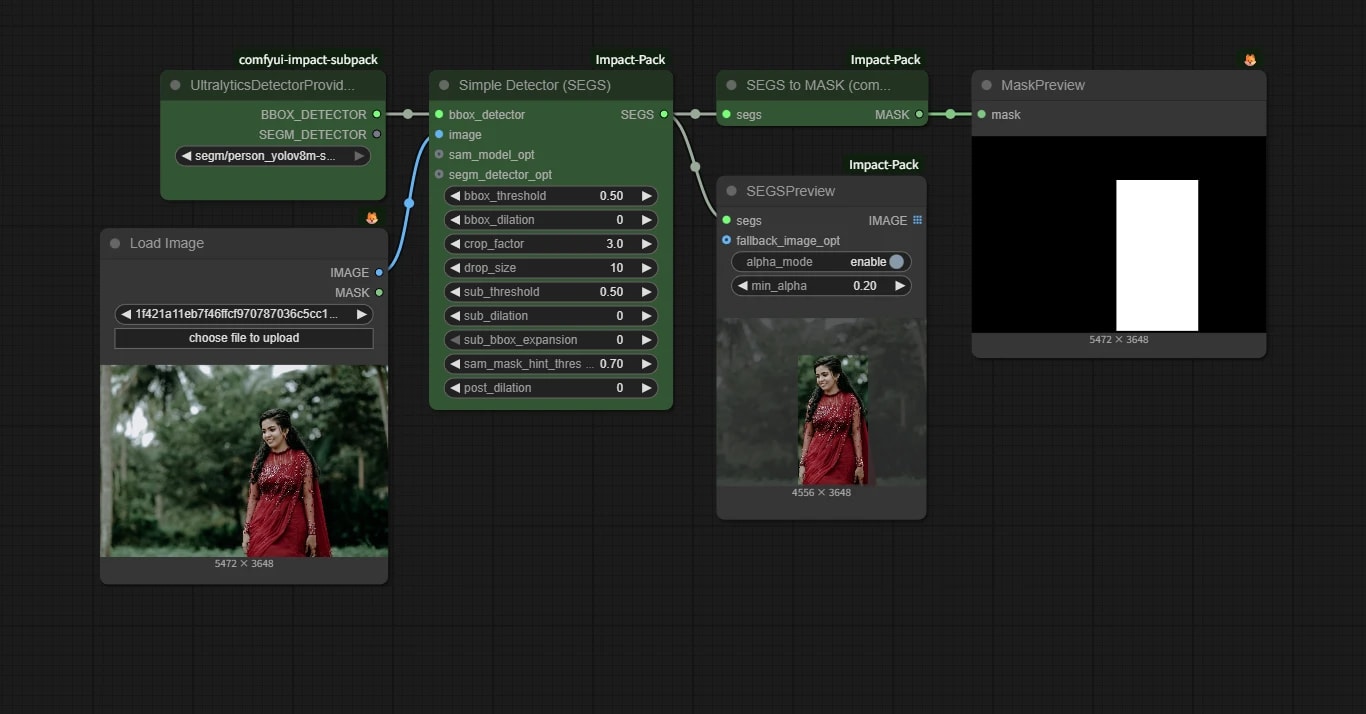
基本上,它会针对想要检测的物体类型分别制作模型,例如人脸专用、手专用等。如果没有对应模型,就需要自己制作;如果想同时检测多种类别,也不太适合。
相对地,它的处理非常轻,适合需要高速处理的情况。
Grounding DINO 等
Grounding DINO 会检测用文本指定的物体,并输出 BBOX。
与 YOLO 不同,可以用 “white dog”、“red car” 这样的文本指定物体,因此使用方便,也可以同时检测多个物体。
VLM / MLLM
拥有看图能力的 LLM,就是 VLM / MLLM。
它们可以进行图像描述生成等各种任务,其中也有可以进行物体检测的模型。
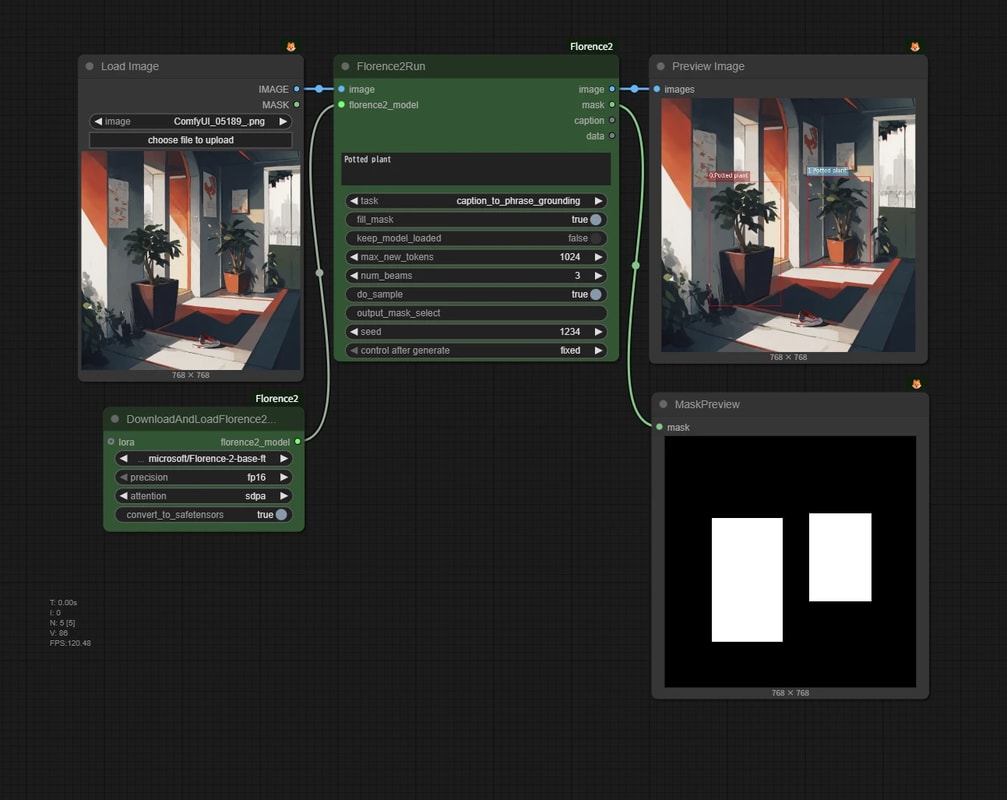
比较早期的代表例是 Florence-2。
速度较慢,但理解能力较高,因此可以用“画面右侧戴着蓝色帽子的女性”这样的复杂句子来指定目标。
抠图 (Matting)
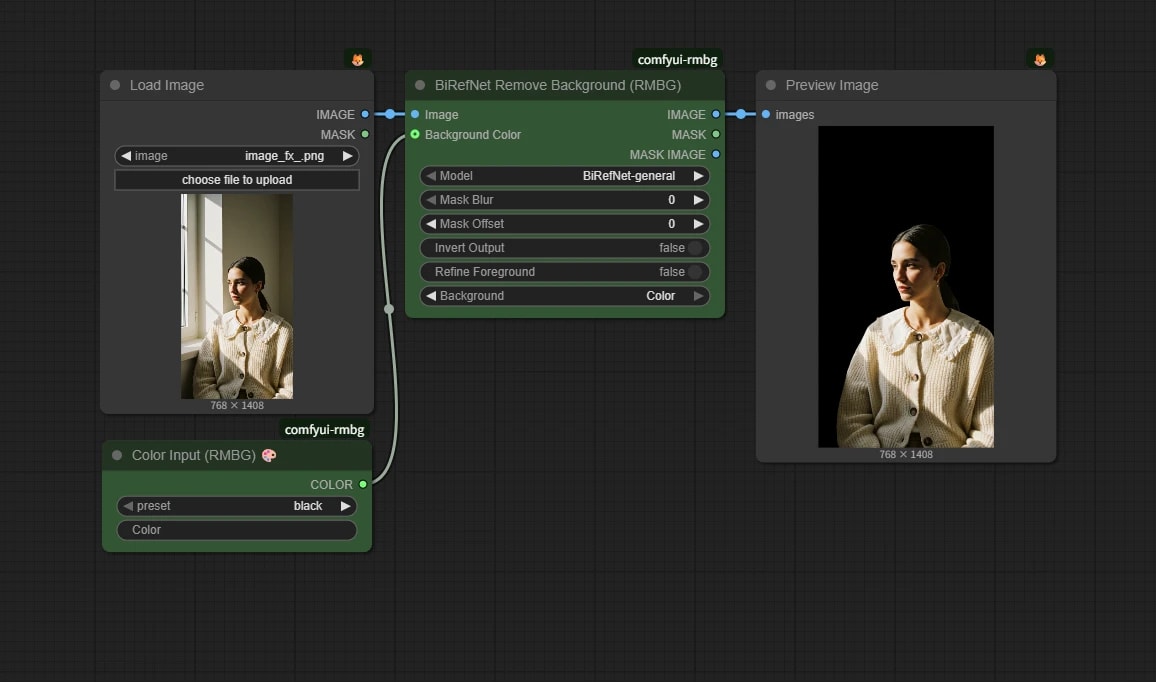
很多被称为“背景去除”的处理,本质上就是抠图。
抠图会分离前景和背景,也可以处理头发这类细小边界,以及半透明区域。
不过,它并不是像分割那样,用来指定并切出某个特定物体的技术。
BiRefNet
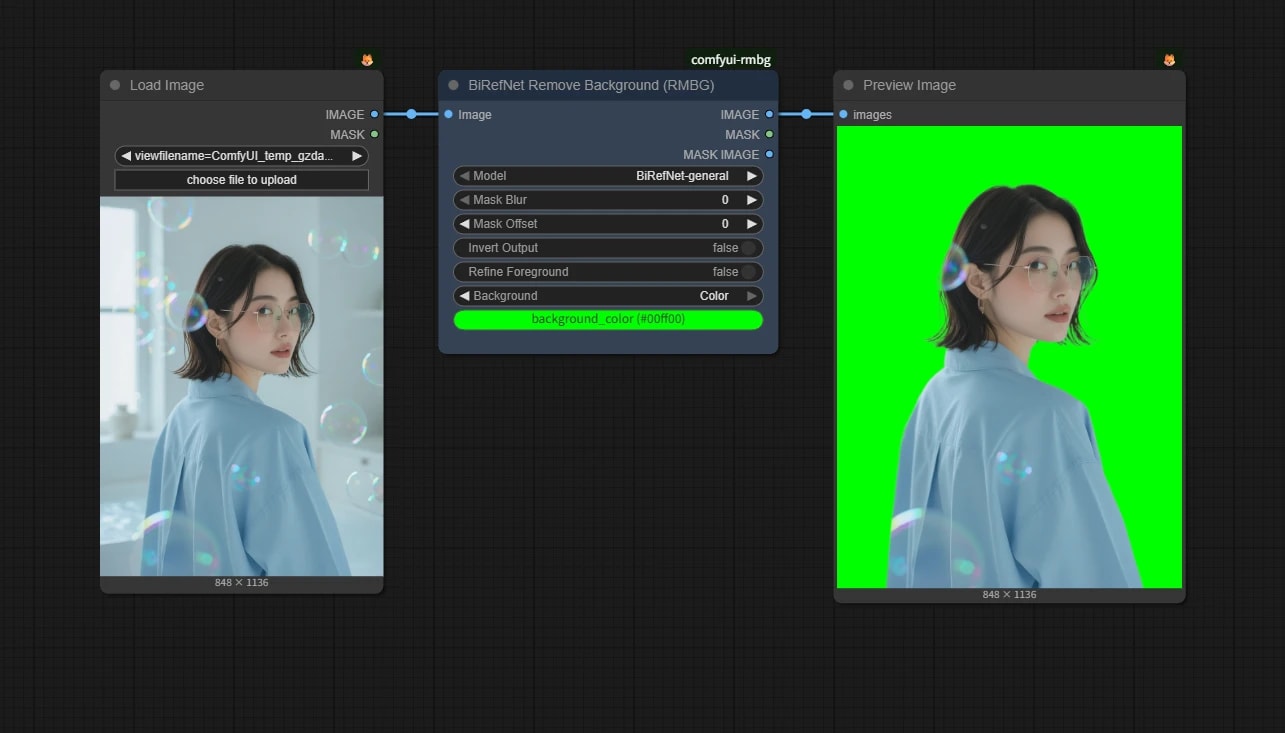
详细用法请看 BiRefNet 页面。
分割 (Segmentation)
SAM (Segment Anything Model)
SAM 是目前最有名的分割模型。
它理解“物体的形状”。如果用文本、点或框指定照片中的汽车等对象,它就能找到轮廓,并生成蒙版。
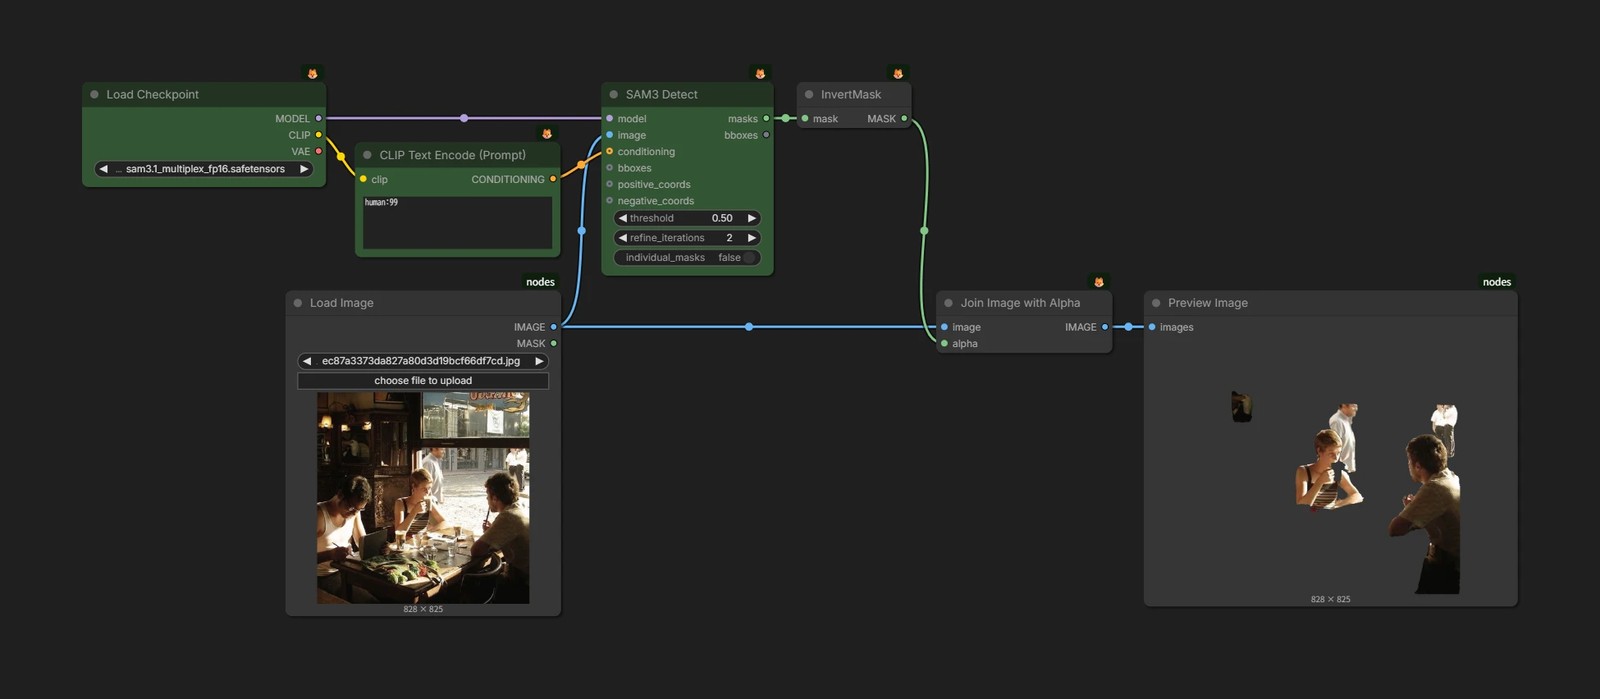
目前最新模型的内容,会在 SAM 3 / 3.1 页面中说明。
实践例
下面组合上述技术,生成任意文本或类别的蒙版。
以下 workflow 是 SAM 3 出现以前经常使用的结构。如果目标是指定对象并进行分割,现在请先尝试 SAM 3 / 3.1。
这里保留下来,是为了方便理解旧 workflow,或在既有环境中复现相同结构。
必要的自定义节点
以下自定义节点可能是运行本页实践例所需要的。
- 1038lab/ComfyUI-RMBG
- 以前从抠图到分割都经常使用。
- 现在 ComfyUI core 中也有 BiRefNet 系背景去除,所以请先确认 core 侧的节点。
- ltdrdata/ComfyUI-Impact-Pack
- ltdrdata/ComfyUI-Impact-Subpack
- 常用于 Detailer 周边。单纯作为蒙版生成使用时稍微有点特殊。
- kijai/ComfyUI-Florence2
- 运行 Florence2 这个 MLLM。
- kijai/ComfyUI-segment-anything-2
- 用于运行 SAM 2 / 2.1 系分割模型。
YOLO × SAM
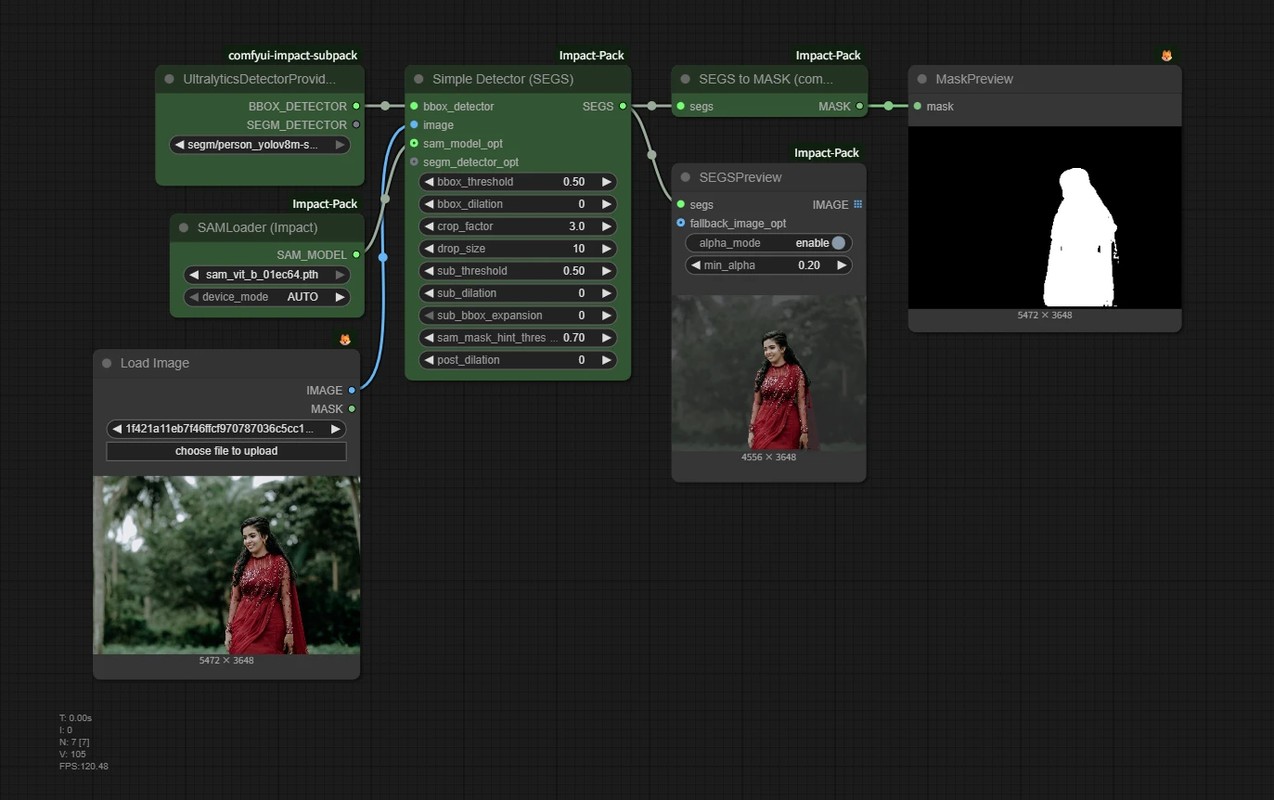
高速人脸检测(YOLO)与初期 SAM 的组合。
Grounding DINO × SAM
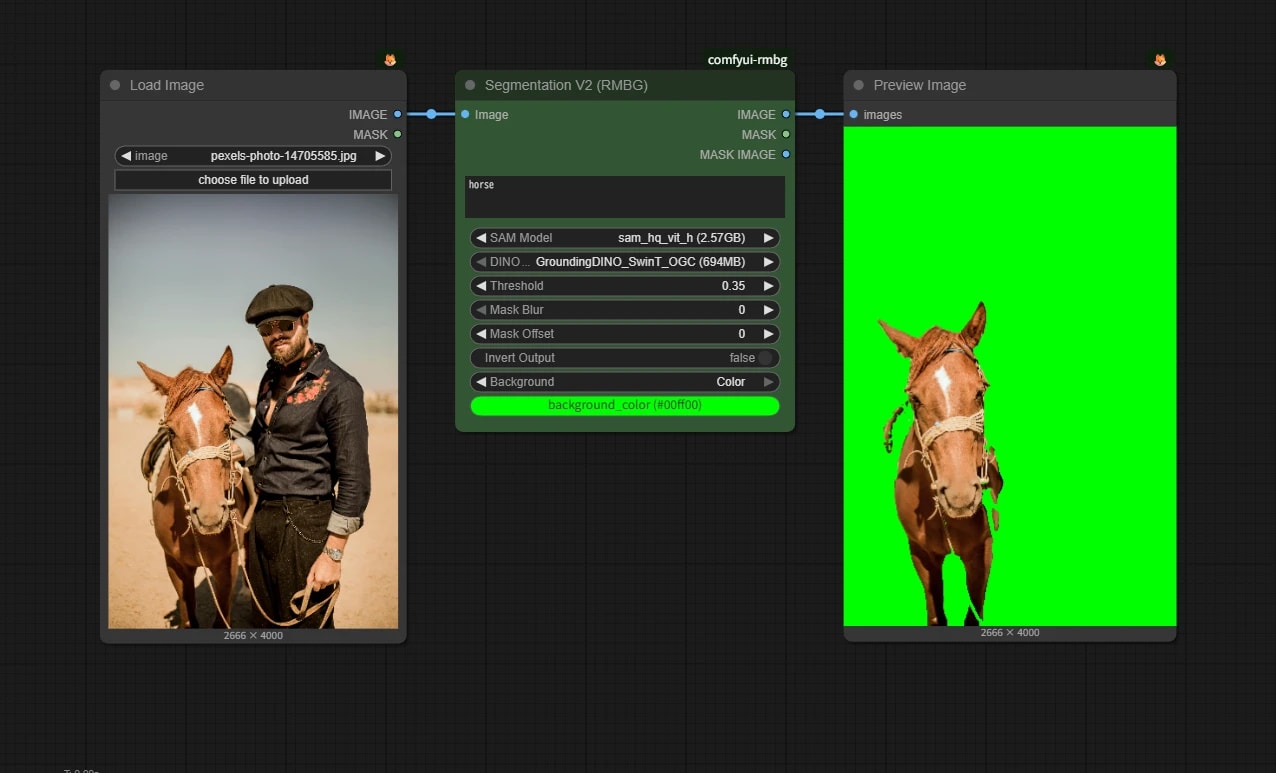
Grounding DINO 与 SAM 改良版 HQ-SAM 的组合。
它可以用文本指定对象,同时生成高精度蒙版,因此曾是最常用的组合之一。
Florence2 × SAM2
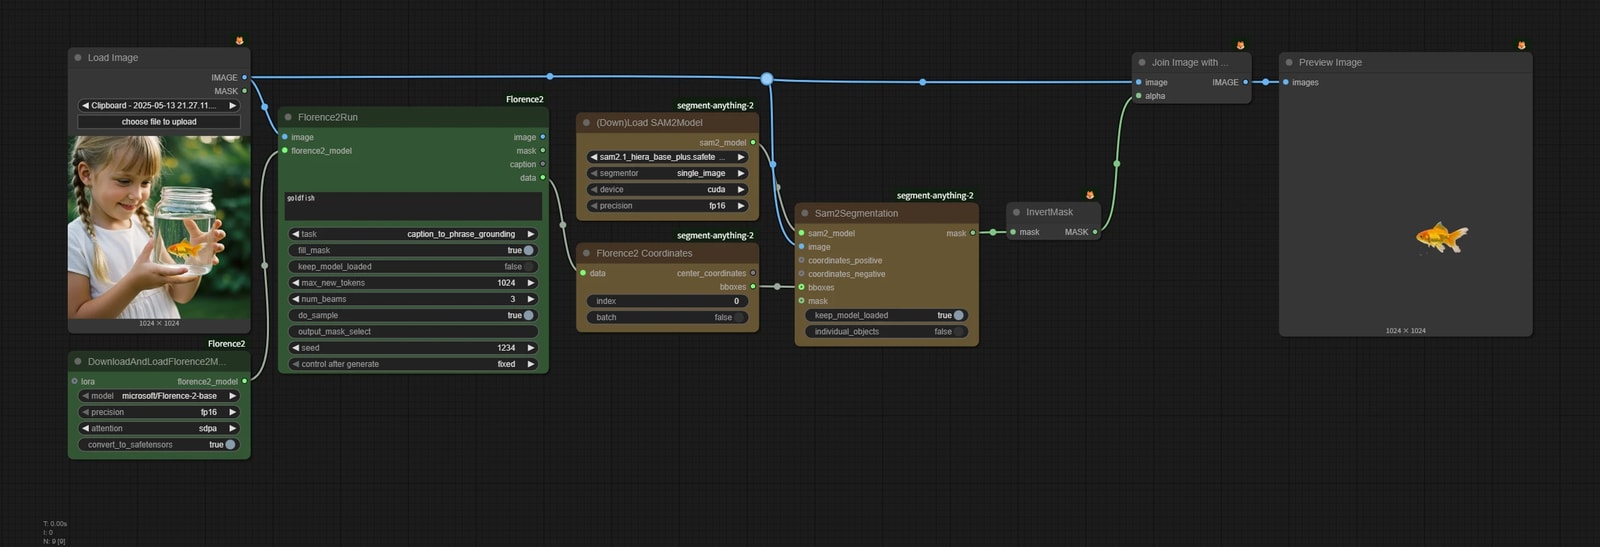
Florence2 与 SAM2.1 的组合。
如果是人或动物等容易理解的对象,很多方法都可以。但如果想指定“戴墨镜的男人”、“躺在树下的猫”这类复杂条件,这种 LLM 系模型就会发挥作用。
SAM 3 × BiRefNet
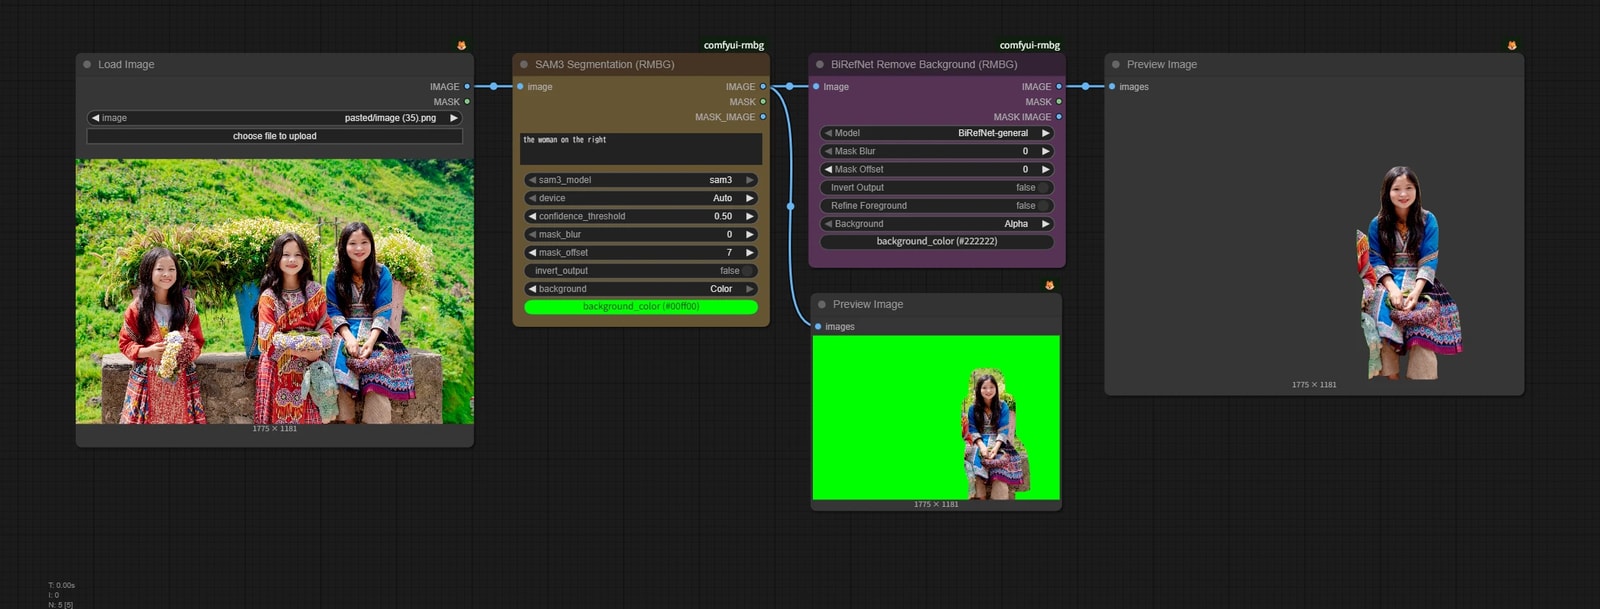
分割本来是为了区分对象,并不是为了精细抠图。
相对地,抠图可以处理头发这种细小部分,也可以处理玻璃这类半透明物体。
把它们组合起来,就可以利用两者的能力。