什么是 JoyCaption?
JoyCaption 是,为了从图像生成说明文的 VLM(Visual Language Model)。
以实写・动漫・数字艺术等,广泛种类的图像为对象可以生成高精度的说明文。尤其是即使是 NSFW 图像也不检阅进行处理,因此即使在更高性能的通用 MLLM 登场的现在,作为“说明文专用模型”也有人气。
由于是以 LLaVA 系的多模态模型为基础,虽然与 tagger 相比不能说是轻量,但在 ComfyUI 的节点作为容易组装进本地的图像生成管道有其简便性。
自定义节点
JoyCaption 节点
从被输入的图像生成说明文。
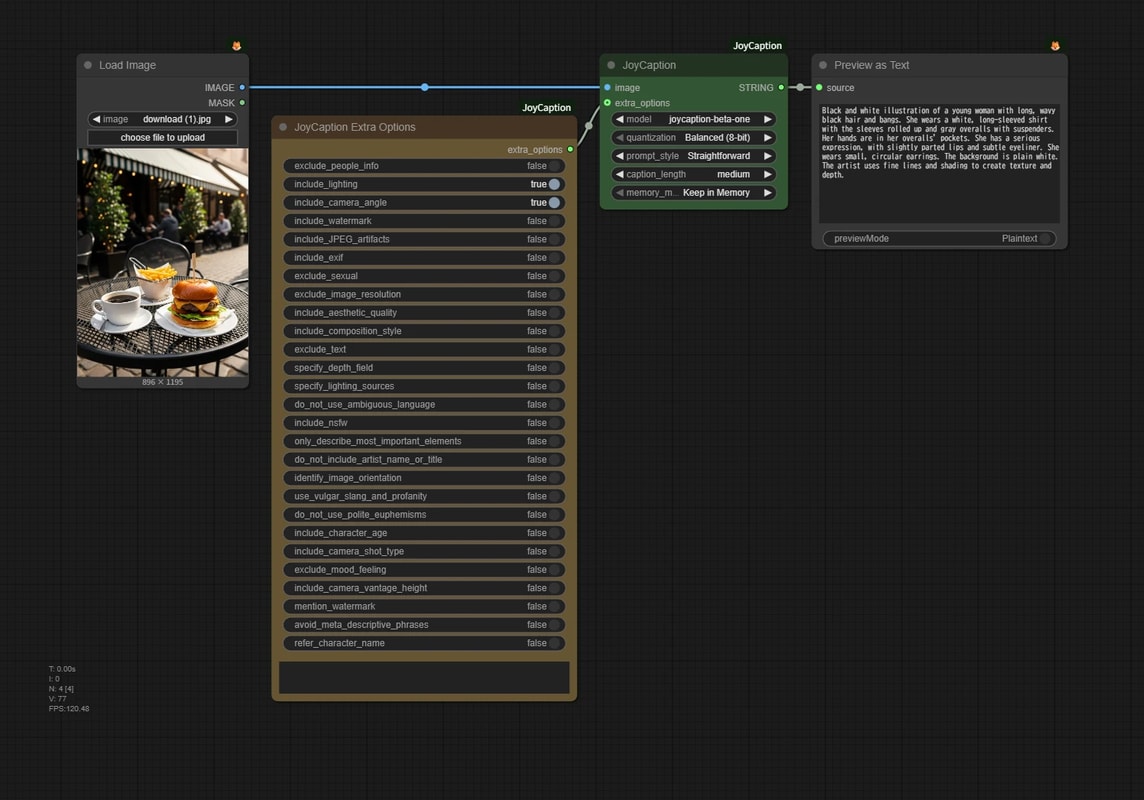
-
prompt_style- Descriptive
- 作为形式且稍长的散文记述。
- 虽然想详细留下图像的内容时便利,但原样用于提示词容易变得冗长。
- Straightforward
- 以简洁且客观的文体记述。
- 是容易原样挪用于提示词或 LoRA 用说明文的风格。
- Stable Diffusion Prompt
- 以面向 Stable Diffusion 的提示词形式记述。
- Danbooru tag list
- 以 Danbooru 的标签形式(例:
1girl,blue_hair)列举标签。
- 以 Danbooru 的标签形式(例:
- Descriptive
-
caption_length- 指定输出的说明文的容量(稍短/稍长)。
-
Extra Options- 设定为了引导说明文生成的追加指示。
- 作为例子,关于相机角度或画质・分辨率、NSFW 要素等,可以指定“详细写/不太触及”这样的方针。