什么是 Lumina-Image 2.0?
Lumina-Image 2.0 是组合了 Unified Next-DiT 和 Flux 系 VAE 的 2.6B 参数的图像生成模型。
采用了 Gemma 2B 系文本编码器,模型本体比 SD3 和 FLUX Pro 相当小,设计目标和 AuraFlow 一样是“比较轻量且日常容易使用的基础模型”定位。 尺寸虽小但提示词遵从性高也是特征,作为次世代基础模型候补之一备受瞩目。
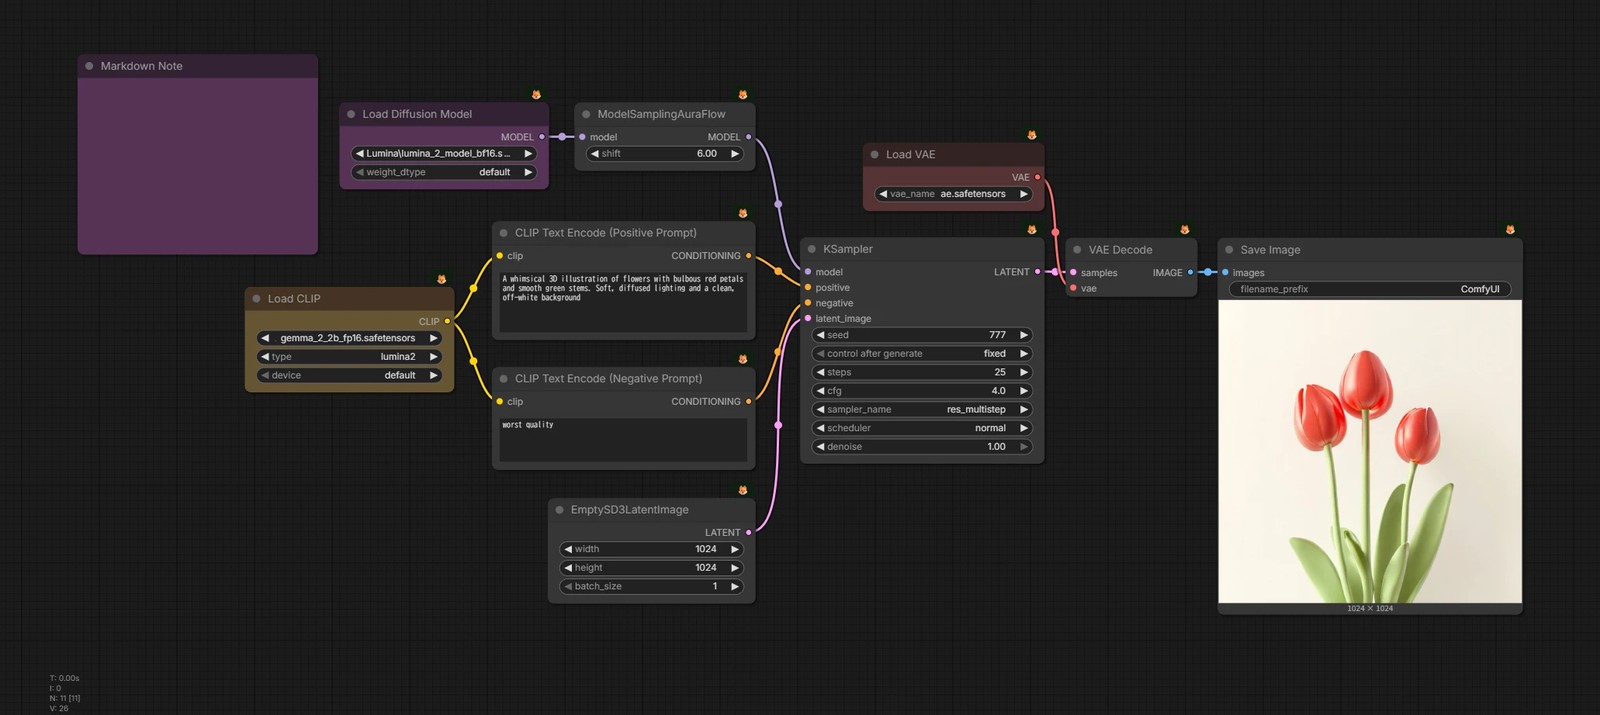
模型的下载
-
diffusion_models
-
text_encoders
-
vae
📂ComfyUI/
└──📂models/
    ├── 📂diffusion_models/
    │   └── lumina_2_model_bf16.safetensors
    ├── 📂text_encoders/
    │   └── gemma_2_2b_fp16.safetensors
    └── 📂vae/
        └── ae.safetensors
text2image
Neta Lumina
Neta-Lumina 是以 Lumina-Image 2.0 为基础的 动漫面向微调模型。
很有动漫模型的风格,也对应 Danbooru 标签,特征是接受中文・英语・日语和多语言的提示词。
模型的下载
-
diffusion_models
📂ComfyUI/
└──📂models/
    └── 📂diffusion_models/
         └── neta-lumina-v1.0.safetensors
text2image
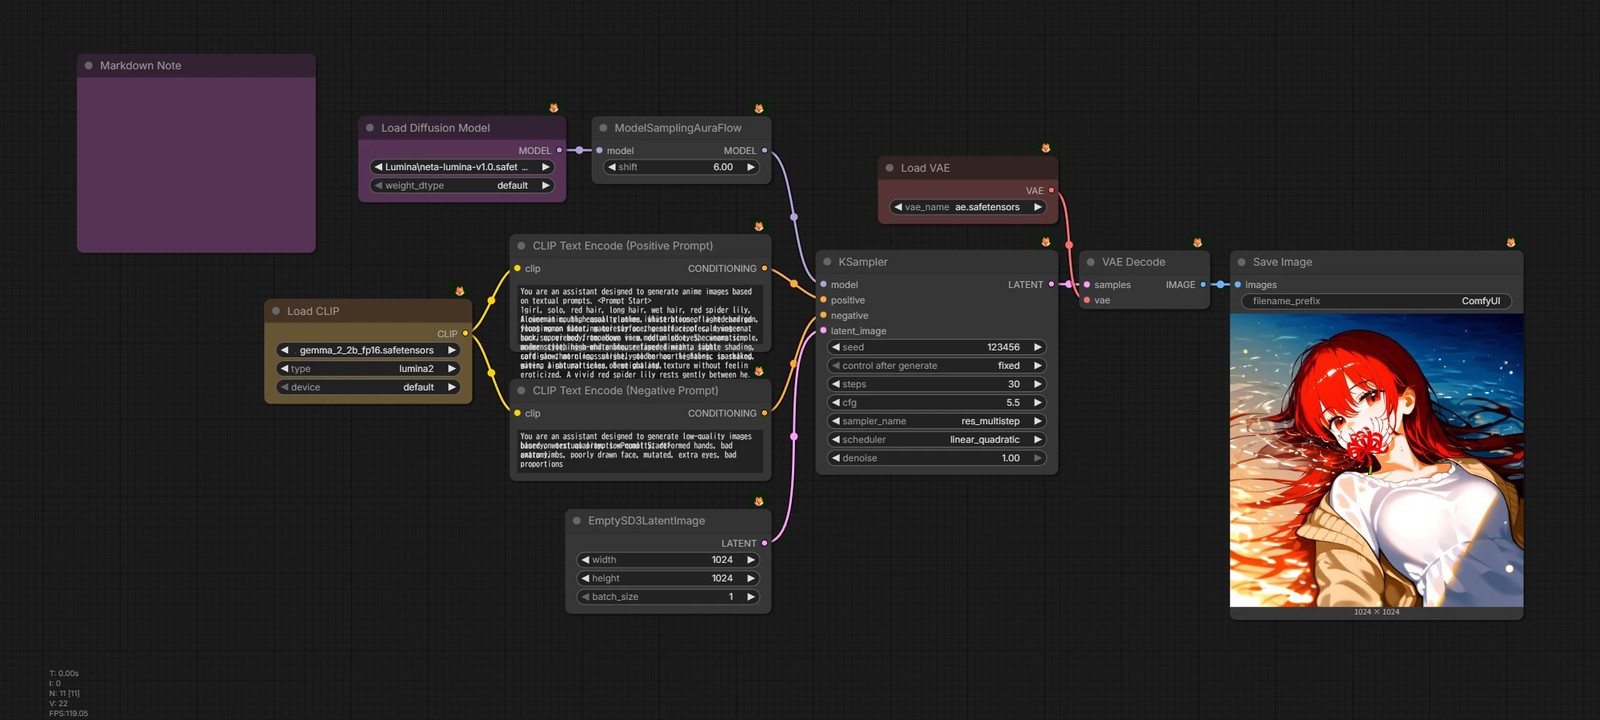
- 采样器遵从官方设定,使用
res_multistep/linear_quadratic。
提示词稍微有特征,需要在实际想让其画的文本前写 系统提示词。
You are an assistant designed to generate anime images based on textual prompts. <Prompt Start>
1girl, portrait, ...
详情请参照官方的 Prompt Book。
NetaYume Lumina
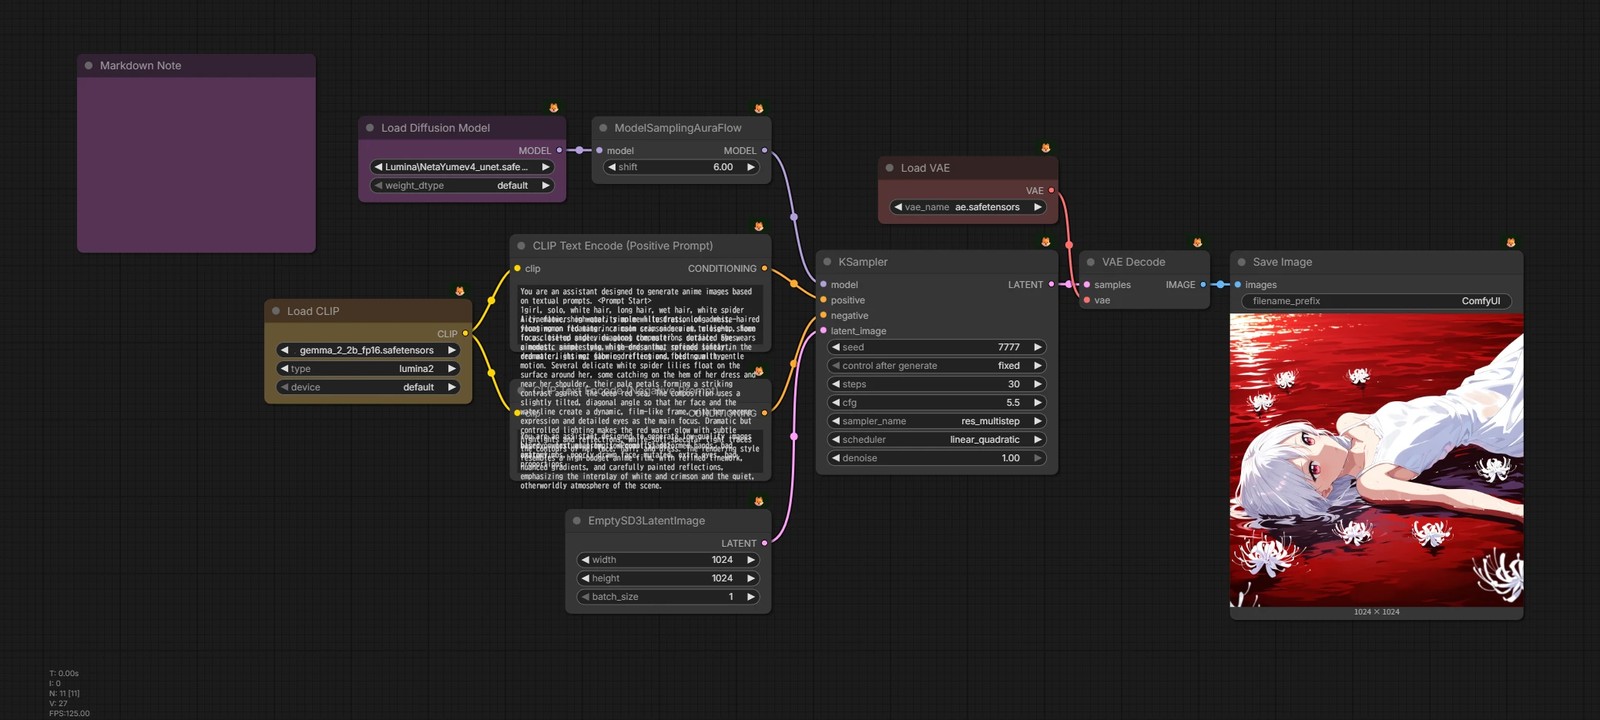
也有以 Neta Lumina 为基础,进一步微调的名为 NetaYume Lumina 的模型。
机会难得,这里也介绍一下吧。
模型的下载
-
diffusion_models
📂ComfyUI/
└──📂models/
    └── 📂diffusion_models/
         └── NetaYumev4_unet.safetensors
text2image
NewBie image Exp0.1
NewBie-image(Exp0.1)是立足于 Lumina 架构研究的知识,以 Next-DiT 为地基设计的 NewBie 独自架构的动漫面向 T2I 模型。使用了更强力的文本编码器,设计为能用 XML 形式提示词(结构化标签)进行更细致地控制。
这个模型还只进行了 20% 的训练。根据今后的更新,workflow 可能会有变更。
模型的下载
-
diffusion models
-
text encoders
-
vae
📂ComfyUI/
└──📂models/
    ├── 📂diffusion_models/
    │   └── NewBie-Image-Exp0.1-bf16.safetensors
    ├── 📂text_encoders/
    │   ├── gemma_3_4b_it_bf16.safetensors
    │   └── jina_clip_v2_bf16.safetensors
    └── 📂vae/
        └── ae.safetensors
text2image
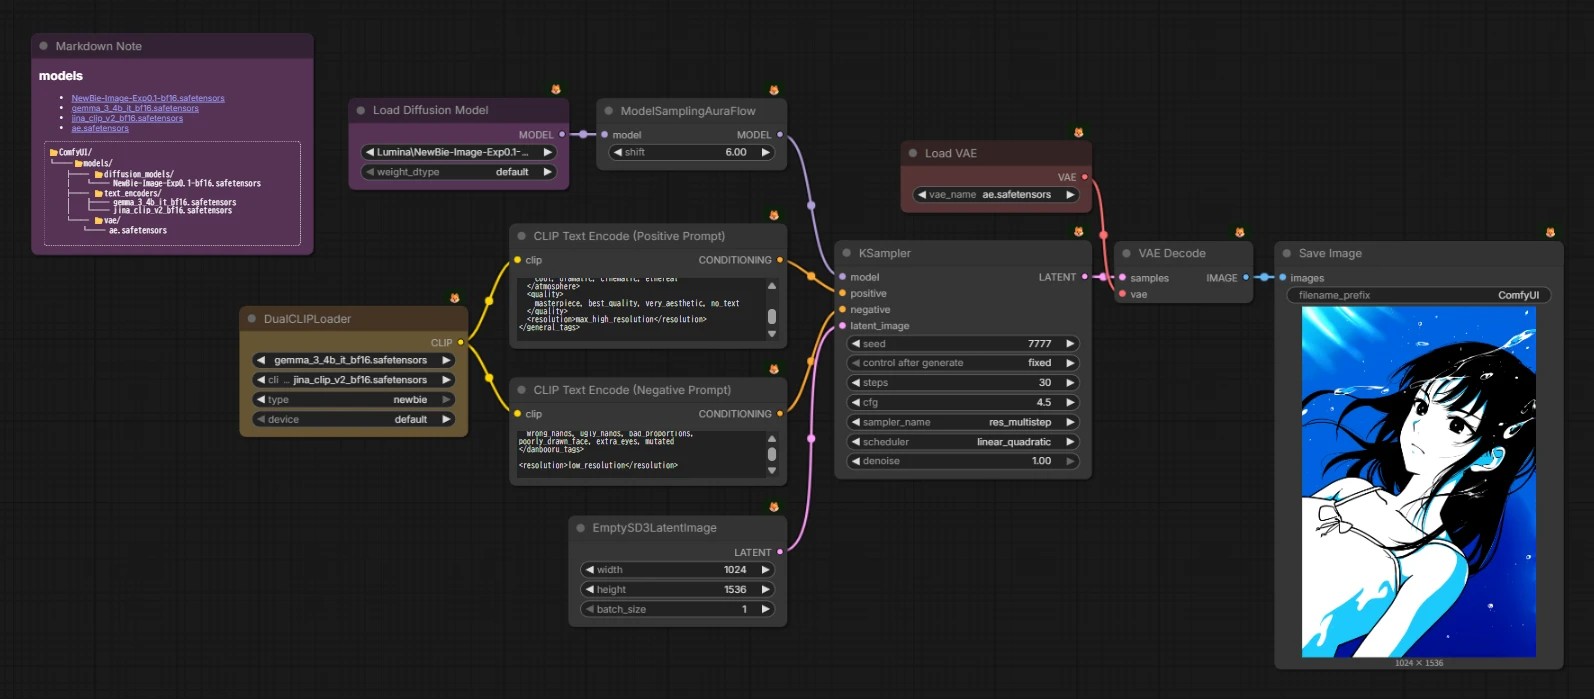
提示词推荐 XML 形式(用标签区隔的结构化)。
<general_tags>
  <style>
    anime_style, key_visual, official_art, illustration,
    refined_lineart, clean_lineart, high_contrast
  </style>
  <background>
    underwater, deep_blue_water, water_surface, waterline,
    caustics, light_rays, reflections
  </background>
</general_tags>
虽说如此,用自然语言写也能没问题地生成,所以首先请轻松地尝试一下。
详情请参照官方的提示词指南。